TPU 8tx và 8i Max, bộ sưu tập 4 TPU thế hệ 8 của Google có ý nghĩa gì cho việc quay lại vị trí số 1? | Viết bởi Pnghuy
Chỉ trong một năm, Google đã giới thiệu tới bốn hệ thống TPU thuộc cùng thế hệ thứ 8. Sau TPU 8t và TPU 8i ra mắt tại Google Cloud Next hồi tháng 4, Google vừa bổ sung thêm TPU 8tx và TPU 8i Max , đây là lần đầu tiên Google đưa ra bốn cấu hình hệ thống riêng biệt trong cùng một năm. Vậy tại sao Google không làm một con TPU dùng chung cho mọi việc mà lại tách ra thành bốn hệ thống riêng như vậy?
Chỉ trong một năm, Google đã giới thiệu tới bốn hệ thống TPU thuộc cùng thế hệ thứ 8. Sau TPU 8t và TPU 8i ra mắt tại Google Cloud Next hồi tháng 4, Google vừa bổ sung thêm TPU 8tx và TPU 8i Max , đây là lần đầu tiên Google đưa ra bốn cấu hình hệ thống riêng biệt trong cùng một năm. Vậy tại sao Google không làm một con TPU dùng chung cho mọi việc mà lại tách ra thành bốn hệ thống riêng như vậy?
TPU giờ cũng không còn là món đồ Google chỉ dùng trong nhà nữa. Theo Google, TPU đang là một mảng kinh doanh tăng trưởng nhanh với gần 100 khách hàng, từ các phòng lab AI tiên phong (frontier lab), công ty giao dịch, nhà bán lẻ cho tới trường đại học. Khách hàng càng đa dạng thì bài toán của họ càng khác nhau, có bên cần huấn luyện mô hình khổng lồ, có bên cần phản hồi thật nhanh, có bên lại cần giữ dữ liệu tuyệt mật và đó cũng là chỗ để bắt đầu trả lời câu hỏi ở trên.
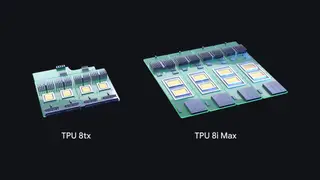
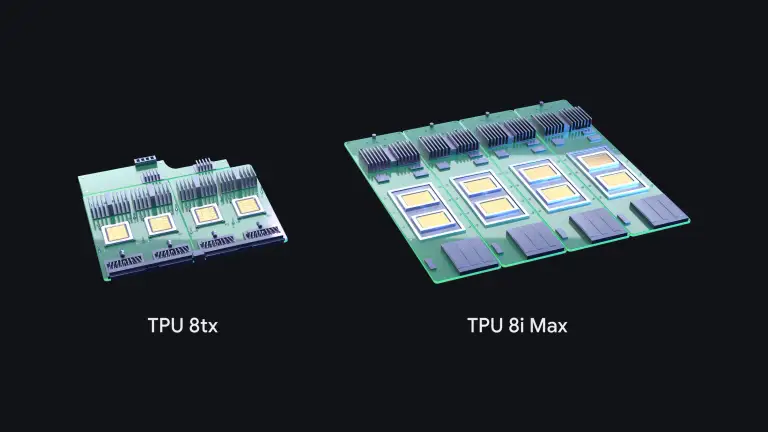
Hai thành viên mới là TPU 8tx và TPU 8i Max và cả hai đều xây trên nền hai con chip Google đã có. WCCFTech mô tả khá gọn, TPU 8tx là phiên bản sửa đổi của TPU 8t, còn TPU 8i Max ghép hai chip TPU 8i vào một gói chip (package) duy nhất.
Nền tảng đó đã được Google trình làng hồi tháng 4. TPU 8t chuyên cho huấn luyện (training) quy mô lớn, TPU 8i chuyên cho suy luận (reasoning) thời gian thực. Google cho biết so với thế hệ TPU trước, TPU 8t cho hiệu năng huấn luyện tốt hơn tới 2.7 lần, còn TPU 8i cho hiệu năng trên giá thành khi chạy suy luận (inference price performance) tốt hơn 80%.
Nói cách khác, Google không vẽ thêm hai con chip mới mà lấy hai con chip sẵn có rồi dựng thành hai cái máy khác hẳn. Chuyện này nghe thì đơn giản nhưng lại là mấu chốt của cả bài.
Vì sao là "hệ thống mới" chứ không phải "chip mới"?
Google phân biệt rất rõ hai chuyện này. Thiết kế một con chip mới là bố trí hàng tỷ transistor siêu nhỏ lên một tấm wafer silicon trong một quá trình kéo dài nhiều năm. Còn một hệ thống mới là cách Google ghép phần tính toán (compute), mạng và lưu trữ xung quanh con chip, kể cả cách đóng gói chip, để đáp ứng nhanh nhu cầu mới của khách hàng.
Bạn có thể hình dung thế này, con chip giống như động cơ, còn hệ thống là cả chiếc xe. Làm một động cơ mới mất nhiều năm, nhưng lấy cùng động cơ đó lắp vào một khung xe khác, đổi hộp số, đổi bánh thì nhanh hơn nhiều mà vẫn ra một chiếc xe chạy khác hẳn.
Theo Google, nhờ kết hợp silicon tùy biến dạng module với một stack phần mềm mở và dễ dùng, hãng có thể tung ra cấu hình phần cứng và hệ thống mới theo kịp tốc độ của ngành AI. ServeTheHome cũng nhấn mạnh đúng điểm này, bốn cấu hình hệ thống trong một năm nhưng không phải bốn thiết kế chip mới.
TPU 8tx giải quyết bài toán gì?
Bài toán của TPU 8tx là chạy AI ngay cạnh dữ liệu nhạy cảm nhất mà không để lộ dữ liệu đó. Google nói hệ thống thứ ba của thế hệ 8 được tối ưu cho suy luận bảo mật (confidential inference) và cũng hợp cho huấn luyện quy mô nhỏ. Khách hàng mục tiêu là doanh nghiệp chịu quản lý chặt và cơ quan chính phủ, những nơi chạy mô hình tiên phong hoặc mô hình độc quyền cùng các agent tự động.
Về phần cứng, TPU 8tx dùng chung silicon với TPU 8t nhưng ghép với CPU host AMD EPYC thế hệ 5. Google cho biết cách làm này đưa bảo mật vào thẳng tầng phần cứng, dữ liệu nhạy cảm và trọng số mô hình được bảo vệ và cô lập ngay cả khi đang được xử lý.
Chi tiết đáng tiền nhất nằm ở chỗ Google đổi CPU. Google đã bỏ CPU Axion dùng kiến trúc Arm do chính hãng tự làm để chuyển sang AMD EPYC. Lý do là chip AMD có sẵn cơ chế gốc tin cậy (root of trust) và bộ tăng tốc mã hóa, nên dữ liệu chạy trên TPU 8tx được mã hóa cho tới đúng lúc cần dùng và được mã hóa lại ngay khi TPU xử lý xong. ServeTheHome nói cụ thể hơn, đó là EPYC Turin, được chọn để khớp giao diện PCIe Gen5 x16 của TPU 8t. Cấu hình hai socket Turin cho 128 làn PCIe Gen5, đủ để bốn TPU và các card mạng tốc độ cao không phải tranh nhau băng thông.
TPU 8tx cũng được dùng mạng Boardfly độ trễ thấp vốn được làm cho TPU 8i. Google cho biết nhờ vậy độ trễ thấp hơn tới 2 lần so với TPU 8t, mức đánh đổi hiệu năng gần như bằng không, giúp các agent chạy nhiều bước liên tiếp không bị chậm. The Register giải thích phần "vì sao": đổi sang Boardfly thì một pod TPU 8tx chỉ còn 1.152 bộ tăng tốc thay vì 9.600 như TPU 8t, đường kính mạng nhỏ hơn 8.3 lần nên mạng phẳng hơn, độ trễ trung bình còn khoảng một nửa.
Với TPU 8tx, các đội kỹ thuật có thể tinh chỉnh (fine-tune) mô hình bằng dữ liệu riêng, chưng cất (distill) mô hình lớn thành mô hình nhỏ và huấn luyện agent bằng học tăng cường (reinforcement learning), tất cả mà không phải chuyển dữ liệu nhạy cảm qua lại giữa các cụm máy riêng. Khi ServeTheHome hỏi, Google trả lời rằng nếu dữ liệu bắt buộc phải nằm trong vùng điện toán bảo mật (confidential computing) thì nên dùng luôn TPU 8tx cho cả khâu suy luận lẫn phục vụ (serving).
TPU 8i Max "gấp đôi" như thế nào?
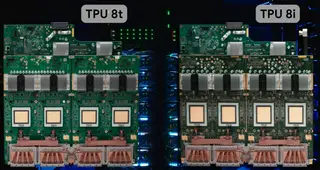
TPU 8i Max sinh ra vì một nút thắt cổ chai rất cụ thể, đó là băng thông bộ nhớ. Google lấy ví dụ khi hàng chục AI agent cùng làm việc trên cả một kho mã nguồn (codebase) hay xử lý hàng giờ video một lúc, bộ nhớ không đẩy dữ liệu kịp cho bộ xử lý. Cách giải của Google là ghép hai chip TPU 8i vào một gói chip.
Kết quả, theo Google, là gấp đôi compute, gấp đôi SRAM và gấp đôi băng thông HBM (bộ nhớ băng thông cao) so với một TPU 8i. SRAM là bộ nhớ tốc độ cao nằm ngay bên trong chip, còn HBM là các chồng bộ nhớ đặt sát cạnh chip. Bạn có thể coi SRAM như mặt bàn làm việc, HBM như cái kệ ngay sau lưng, mặt bàn càng rộng và đường lấy đồ từ kệ càng nhanh thì người làm càng ít phải ngồi chờ.
Google không công bố con số cụ thể, nên phần số liệu là do báo chí tự tính. WCCFTech tính ra TPU 8i Max có tới 768 MB SRAM, đồng thời lưu ý Google chưa xác nhận dung lượng HBM. ServeTheHome thì đưa ra con số 384 GB HBM, nhiều hơn khoảng một phần ba so với TPU 8i, còn băng thông tăng gấp đôi lên 17.2 TB/s.
Khoan, gấp đôi chip mà dung lượng chỉ tăng một phần ba? The Register soi ra lý do. Mỗi chip trong TPU 8i Max chỉ còn 192 GB HBM, ít hơn 33% so với 288 GB của con TPU 8i gốc, trong khi băng thông mỗi chip vẫn giữ 8.6 TB/s. Tức là số chồng HBM trên mỗi chip không đổi nhưng mỗi chồng mỏng hơn. Như vậy thứ được nhân đôi là băng thông chứ không phải dung lượng và băng thông cũng chính là chỗ Google nói đang bị nghẽn.
Một lợi ích nữa nằm ở trung tâm dữ liệu. Theo Google, TPU 8i Max nhét được gấp đôi silicon trong cùng diện tích tủ máy chủ (rack) hiện có, nên mỗi mét vuông và mỗi watt điện đều có thể gánh nhiều sức tính toán hơn đáng kể. Có một chi tiết nhỏ chưa có lời giải, The Register nhận thấy cổng ICI (kết nối giữa các chip) ở cạnh dưới card TPU 8i Max trông khác các socket TPU 8 còn lại và Google chưa giải thích điểm này.
Bốn hệ thống TPU thế hệ 8 có vai trò ra sao?
Google nói rõ ý đồ là mỗi giai đoạn trong vòng đời của một ứng dụng AI tự hành (agentic) có một bộ tăng tốc được làm đúng cho việc đó:
TPU 8t (scale-up training): huấn luyện mô hình nền tảng khổng lồ, tối đa hóa "goodput", tức lượng trí tuệ hữu ích làm ra trên mỗi watt điện. TPU 8i (low-latency reasoning): suy luận độ trễ thấp, được thiết kế để phá "bức tường bộ nhớ" và giảm độ trễ giao tiếp giữa các chip tới một nửa. TPU 8tx (confidential computing): chạy AI trên dữ liệu nhạy cảm với bảo mật ở tầng phần cứng. TPU 8i Max (massive context windows): phục vụ cửa sổ ngữ cảnh (context window) khổng lồ và mật độ tính toán cao nhất trên mỗi tủ máy chủ.
TPU 8t là cỗ máy lớn nhất trong nhóm. Theo Google, một superpod (cụm siêu máy tính) TPU 8t mở rộng tới 9.600 TPU với 2 petabyte HBM dùng chung, sức xử lý gấp ba Ironwood (TPU thế hệ 7) và hiệu năng trên mỗi watt tốt hơn tới 2 lần. Con số 9.600 chip này cũng giải thích vì sao TPU 8t cần một hệ thống riêng, nó được làm để gom thật nhiều chip lại cho một việc huấn luyện.
TPU 8i thì đi hướng ngược lại, ưu tiên phản hồi nhanh. Google cho TPU 8i 288 GB HBM và 384 MB SRAM, gấp 3 lần thế hệ trước, để phần dữ liệu mô hình đang dùng tới nằm trọn trong chip. Mạng Boardfly của nó cũng được dựng cho độ trễ. Tom's Hardware mô tả Boardfly gồm ba tầng, khối 4 chip nối bằng cáp đồng thành nhóm 32 chip, rồi 36 nhóm nối qua bộ chuyển mạch quang thành một pod tới 1.024 chip hoạt động. Với 1.024 chip xếp theo kiểu 3D Torus cũ, một gói dữ liệu trong trường hợp xấu nhất phải đi qua 16 chặng, Boardfly cắt xuống còn 7. Điều này có lợi cho các mô hình MoE (mixture-of-experts), nơi các chip phải liên tục trao đổi dữ liệu với nhau.
Nhìn vào đây thì TPU 8tx và TPU 8i Max không phải hai nhánh mới mà là hai biến thể của hai nhánh cũ. TPU 8tx lấy silicon của 8t cộng mạng của 8i cộng CPU AMD, còn TPU 8i Max là hai con 8i đóng chung một gói.
Phần mềm mới là mảnh ghép còn lại
Vế thứ hai trong công thức "silicon module cộng phần mềm mở" của Google là phần mềm và đợt này Google tung ra khá nhiều thứ để developer ít phải viết lại code khi chuyển sang TPU.
Tháng trước, Google đã mở mã nguồn (open-source) TorchTPU, giúp code PyTorch và mô hình Hugging Face chạy trực tiếp trên TPU, kèm sẵn backend TPU cho các công cụ chạy suy luận mã nguồn mở như vLLM và SGLang. Google cũng có bộ công cụ TPU agent mã nguồn mở (đang ở bản preview) cắm thẳng vào các công cụ lập trình như Claude Code, Cursor và Google Antigravity. Bạn chỉ cần ra lệnh bằng ngôn ngữ thường, bộ công cụ sẽ tự lo việc làm quen TPU trong vài phút, chẩn đoán chỗ nghẽn và tự tinh chỉnh kernel. Còn XLA Serving Engine, cũng mã nguồn mở, cho phép huấn luyện mô hình bằng Python rồi chạy thẳng trong một runtime C++ độ trễ thấp, trên cả TPU, GPU lẫn CPU.
Món có nhiều thứ để nói nhất là TPU Sync, cũng đang được mở mã nguồn. Nó gộp HBM của chip, RAM của máy host, bộ lưu trữ dùng chung và mạng trung tâm dữ liệu thành một hệ thống bộ nhớ nhiều tầng. TPU Sync tự đẩy KV cache (bộ nhớ đệm lưu ngữ cảnh đã xử lý của mô hình) ra khỏi chip trong vài mili giây, chuyển ngữ cảnh giữa các máy làm khâu prefill (đọc prompt) và decode (sinh token) tách rời và đồng bộ trọng số khi huấn luyện tăng cường. Theo Google, nhờ vậy thời gian chuyển KV cache và thời gian ra token đầu tiên (Time to First Token) giảm hơn 90%. The Register bổ sung rằng vì TPU Sync là phần mềm nên Google đã đưa nó ngược về cả TPU 5, TPU 6, TPU 7 chứ không chỉ TPU 8.
Ở khâu vận hành, Agent Compute Engine tự tạm dừng và khởi động lại các phiên agent đang ngồi chờ, vì agent hay phải đợi vài giây tới vài giờ để chờ database, công cụ bên ngoài hay phản hồi của con người. Cloud Pathways, runtime của Google DeepMind đứng sau Gemini, giờ đã chính thức có trên GKE, cho phép điều khiển cả một hệ TPU lớn như một máy duy nhất và thay nóng phần cứng hỏng trong chưa tới một phút. GKE dynamic slicing (cũng đã chính thức) dùng chuyển mạch quang để gộp hay chia nhỏ các khối TPU theo nhu cầu, giúp khởi động job nhanh hơn tới 5 lần và khôi phục sự cố nhanh hơn tới 4.5 lần.
Google cho biết trên hai bài đo hiệu năng InferenceX và AgentX, vốn mô phỏng việc viết code bằng agent và xử lý ngữ cảnh dài, bộ vLLM chạy trên TorchTPU đạt mức hiệu năng trên giá thành dẫn đầu. Và vòng lặp cũng khép lại theo kiểu rất Google, hãng dùng hệ thống AlphaChip của DeepMind và Gemini để làm layout chip trong vài giờ thay vì vài tuần, tức là dùng AI chạy trên TPU để thiết kế TPU đời sau.
Nhưng câu chuyện không chỉ có màu hồng
Những gì Google nói chỉ là bề nổi. Đọc thêm báo chí quốc tế thì có khá nhiều điểm còn bỏ ngỏ.
Trước hết là thời điểm. Bài công bố của Google không nói khi nào TPU 8tx và TPU 8i Max có hàng. The Register cho biết các bản sửa đổi này dự kiến được lắp đặt trong năm 2027 và tự dự đoán một cách lạc quan là bắt đầu từ quý 1/2027 rồi mất thêm khoảng một năm rưỡi mới có mặt ở nhiều vùng Google Cloud. Cũng theo The Register, TPU 8t do bộ phận thiết kế chip của Broadcom làm cho Google và đang vào trung tâm dữ liệu, còn TPU 8i do MediaTek phụ trách, từng bị chậm hồi đầu năm và hiện chưa rõ đã giao cho Google hay chưa. Giá thuê cũng chưa có, The Register chỉ đoán TPU 8tx sẽ đắt hơn một chút theo giờ so với 8t và 8i, còn TPU 8i Max rẻ hơn một chút so với gấp đôi giá TPU 8i.
TPU Sync cũng còn dấu hỏi. The Register thẳng thắn nói chưa hiểu TPU Sync điều phối dữ liệu qua lại giữa HBM, RAM host, flash và ổ lưu trữ bên ngoài trên hàng chục nghìn tới hàng triệu TPU bằng cách nào và cũng chưa biết nó tăng thông lượng (throughput) suy luận được bao nhiêu. Con số "hơn 90%" ở trên là về độ trễ, không phải về số công việc làm được.
Rồi chuyện sức mạnh từng con chip. Tom's Hardware dẫn tài liệu của Google cho biết TPU 8t đạt 12.6 PFLOPS FP4 với 216 GB HBM3e, TPU 8i đạt 10.1 PFLOPS FP4 với 288 GB HBM3e. Trong khi đó Vera Rubin R200 của NVIDIA đạt 35 PFLOPS FP4 với 288 GB HBM4, MI455X của AMD đạt 40 PFLOPS FP4 với 432 GB HBM4, tức là tính theo sức tính toán thô trên mỗi socket, chip của NVIDIA và AMD hơn TPU 8t khoảng 3 lần. Tom's Hardware, dẫn phân tích của The Next Platform, cho rằng việc dùng HBM3E thay vì HBM4 là đánh đổi có chủ đích để giảm giá mỗi chip và tăng tỷ lệ chip đạt chuẩn, TPU 8t có dung lượng bộ nhớ nhiều hơn Ironwood 12.5% nhưng băng thông lại thấp hơn 11.5%.
Nhưng đây cũng là sự thật, Google không chơi cuộc chơi từng con chip. Mark Lohmeyer, phó chủ tịch mảng hạ tầng AI và tính toán của Google, nói với The Register rằng các pod 9.600 TPU 8t được ghép lại thành cụm hơn 1 triệu chip và một cụm như vậy đã được dùng để huấn luyện Gemini 4 Carbon. Người hưởng lợi bất ngờ lại là AMD. ServeTheHome nhận xét việc này chưa thể giúp AMD tăng 10% thị phần CPU máy chủ sau một đêm, nhưng vẫn là một chiến thắng lớn, vì EPYC lọt được vào hệ thống tăng tốc không phải của AMD và thắng một socket ở một ông lớn điện toán đám mây nhờ năng lực bảo mật.
Vậy vì sao Google không làm một con TPU cho tất cả?
Vì mỗi khâu của AI cần một thứ khác nhau và Google đã tìm ra cách đáp ứng nhanh mà không phải vẽ chip mới. Huấn luyện cần gom thật nhiều chip lại với nhau nên có TPU 8t, suy luận cần phản hồi nhanh nên có TPU 8i với SRAM lớn và mạng Boardfly, dữ liệu nhạy cảm cần bảo mật từ phần cứng nên có TPU 8tx, còn ngữ cảnh dài và hàng chục agent chạy cùng lúc cần băng thông bộ nhớ nên có TPU 8i Max.
Hai con chip gốc vẫn là 8t và 8i, phần Google thay đổi là cách ghép CPU, mạng, bộ nhớ và cách đóng gói xung quanh chúng, cộng thêm một lớp phần mềm mở để developer dùng được ngay.
Cái giá phải trả là người dùng phải tự biết mình cần hệ thống nào, trong khi hai hệ thống mới chưa có lịch bán, chưa có giá và xét riêng từng con chip thì TPU vẫn thua NVIDIA, AMD về sức tính toán thô.