Google ra mắt TPU 8tx và TPU 8i Max: bảo vệ dữ liệu cả khi đang xử lý, gộp hai chip vào một gói
Dữ liệu bệnh án hay giao dịch ngân hàng thường được mã hóa khi nằm trong ổ cứng và khi truyền qua mạng. Nhưng lúc máy tính bắt tay vào xử lý, dữ liệu phải được mở ra trong bộ nhớ. Google vừa công bố hai hệ thống TPU mới nhắm vào chỗ này và một nút thắt khác của AI: TPU 8tx bảo vệ dữ liệu ngay trong lúc đang chạy, còn TPU 8i Max gộp hai chip vào một gói để xử lý ngữ cảnh dài hàng triệu token.
Dữ liệu bệnh án hay giao dịch ngân hàng thường được mã hóa khi nằm trong ổ cứng và khi truyền qua mạng. Nhưng lúc máy tính bắt tay vào xử lý, dữ liệu phải được mở ra trong bộ nhớ. Google vừa công bố hai hệ thống TPU mới nhắm vào chỗ này và một nút thắt khác của AI: TPU 8tx bảo vệ dữ liệu ngay trong lúc đang chạy, còn TPU 8i Max gộp hai chip vào một gói để xử lý ngữ cảnh dài hàng triệu token.
Google công bố TPU 8tx và TPU 8i Max ngày 9/11/2026 trên blog chính thức. Đây là hệ thống thứ ba và thứ tư thuộc thế hệ TPU thứ 8, và theo Google, đây là lần đầu hãng giới thiệu bốn hệ thống TPU trong cùng một năm.
TPU 8tx: dữ liệu được bảo vệ ngay cả khi đang xử lý
Theo Google, dữ liệu thường được mã hóa khi lưu trữ hoặc gửi qua mạng, nhưng phải "mở khóa" trong bộ nhớ khi máy tính xử lý. Với dữ liệu y tế, tài chính hay dữ liệu của cơ quan nhà nước, khoảnh khắc đó là điểm cần bảo vệ.
TPU 8tx đưa phần bảo mật xuống tầng phần cứng, giữ dữ liệu nhạy cảm và trọng số mô hình AI được bảo vệ, tách biệt ngay cả khi đang được dùng. Đây là hướng điện toán bảo mật (confidential computing). Hệ thống dùng lại đúng phần silicon của TPU 8t, chip huấn luyện của thế hệ 8, ghép với máy chủ dùng CPU AMD EPYC thế hệ 5 và mạng Boardfly độ trễ thấp vốn làm cho chip suy luận 8i.
Google cho biết cách ghép này giúp TPU 8tx có độ trễ thấp hơn tới 2 lần so với TPU 8t, trong khi hiệu năng gần như không bị ảnh hưởng.
Máy tính thường phải giải mã dữ liệu trong bộ nhớ để xử lý; TPU 8tx giữ dữ liệu và trọng số mô hình tách biệt ngay cả khi đang chạy. Ảnh: Minh họa tự vẽ theo bài viết của Google
Google nhắm TPU 8tx tới doanh nghiệp chịu quản lý chặt và cơ quan chính phủ, những nơi chạy mô hình AI riêng hoặc trợ lý AI tự động trên dữ liệu nhạy cảm nhất của mình. Vì có sức tính của chip huấn luyện và mạng của chip suy luận, 8tx còn dùng được cho huấn luyện quy mô nhỏ: tinh chỉnh mô hình bằng dữ liệu riêng, chưng cất mô hình lớn thành mô hình nhỏ, huấn luyện trợ lý AI bằng học tăng cường, mà không phải chuyển dữ liệu nhạy cảm giữa các cụm máy.
TPU 8i Max: hai chip 8i trong một gói
Vấn đề thứ hai Google muốn giải là "bức tường bộ nhớ". Khi hàng chục trợ lý AI cùng làm việc trên toàn bộ mã nguồn của một phần mềm hay nhiều giờ video, băng thông bộ nhớ nhanh chóng thành nút thắt: chip tính nhanh nhưng không lấy dữ liệu về kịp.
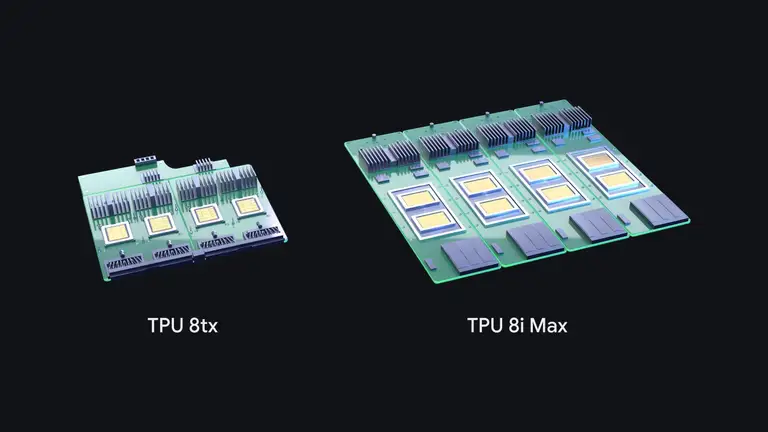
TPU 8i Max gộp hai chip TPU 8i vào chung một gói. Theo Google, hệ thống có gấp đôi sức tính toán, gấp đôi bộ nhớ SRAM trên chip và gấp đôi băng thông bộ nhớ HBM so với TPU 8i. Vì lượng silicon gấp đôi vẫn nằm gọn trong khung rack hiện có, trung tâm dữ liệu đặt được nhiều sức tính hơn trên mỗi mét vuông sàn và mỗi watt điện.
TPU 8i Max gộp hai chip 8i vào một gói: gấp đôi tính toán, SRAM và băng thông HBM so với một TPU 8i. Ảnh: Minh họa tự vẽ theo số liệu Google công bố
Vì sao Google ra được bốn hệ thống TPU trong một năm
Thế hệ TPU thứ 8 bắt đầu từ Google Cloud Next tháng 4/2026 với hai chip: TPU 8t chuyên huấn luyện mô hình lớn và TPU 8i chuyên suy luận thời gian thực. Theo Google, so với thế hệ trước, 8t cho hiệu năng huấn luyện tốt hơn tới 2,7 lần, còn 8i cho hiệu năng suy luận trên chi phí tốt hơn 80%.
8tx và 8i Max không phải chip mới mà là hệ thống mới xây quanh chip đã có. Google giải thích thiết kế một con chip mới mất nhiều năm, còn hệ thống là cách ghép tính toán, mạng, bộ nhớ và đóng gói quanh con chip đó, nên có thể ra mắt trong vài tháng để đáp ứng nhu cầu mới của khách hàng.
Bốn hệ thống TPU thế hệ 8: 8t huấn luyện quy mô lớn, 8i suy luận độ trễ thấp, 8tx điện toán bảo mật, 8i Max ngữ cảnh dài và mật độ tính toán cao. Ảnh: Google
Cùng đợt này, Google nói về phần mềm: TorchTPU (mở mã nguồn từ tháng trước) cho code PyTorch và mô hình Hugging Face chạy trực tiếp trên TPU; bộ công cụ TPU agent suite mã nguồn mở đang ở bản xem trước; XLA Serving Engine mã nguồn mở; Cloud Pathways và GKE dynamic slicing chính thức có trên Google Kubernetes Engine. Google cho biết TPU hiện có gần 100 khách hàng, gồm phòng thí nghiệm AI, công ty giao dịch, nhà bán lẻ và trường đại học.
Chưa có giá, chưa có ngày cung cấp
Bài công bố của Google không nêu giá, ngày cung cấp hay khu vực triển khai cho TPU 8tx và TPU 8i Max. Các con số hiệu năng trong bài đều do Google công bố, chưa có kiểm chứng độc lập.
Với người dùng phổ thông, tác động nếu có sẽ đến gián tiếp qua các dịch vụ chạy trên Google Cloud, chứ không phải từ con chip. Anh em thấy hướng "bảo vệ dữ liệu cả khi đang xử lý" có đủ để ngân hàng, bệnh viện yên tâm đưa dữ liệu lên AI đám mây không?
Nguồn: Google — Our newest TPUs: 8tx and 8i Max, built for the agentic era (9/11/2026)