Claude Fable 5.2 và Mythos 5.2: giảm giá 20%, Fermat 30 giờ, nhưng dùng sao cho đáng?
Hôm 9/11 vừa rồi, Anthropic ra mắt Claude Fable 5.2 và Claude Mythos 5.2, hai mô hình mà hãng nói là dành cho “những thử thách kỹ thuật khó nhất”. Trên tiêu đề, con số dễ nhớ nhất là xuất kết quả nhanh hơn tới 30% và giá API giảm 20%. Nhưng đọc kỹ thông báo của Anthropic, tài liệu cho dev và các bài phân tích của VentureBeat hay The Decoder thì câu chuyện thú vị hơn nhiều: chính Anthropic vẫn khuyên đa số người dùng đừng bắt đầu bằng Fable.
Hôm 9/11 vừa rồi, Anthropic ra mắt Claude Fable 5.2 và Claude Mythos 5.2, hai mô hình mà hãng nói là dành cho “những thử thách kỹ thuật khó nhất”. Trên tiêu đề, con số dễ nhớ nhất là xuất kết quả nhanh hơn tới 30% và giá API giảm 20%. Nhưng đọc kỹ thông báo của Anthropic, tài liệu cho dev và các bài phân tích của VentureBeat hay The Decoder thì câu chuyện thú vị hơn nhiều: chính Anthropic vẫn khuyên đa số người dùng đừng bắt đầu bằng Fable.
Trong bài này mình gom lại những điểm đáng chú ý: Fable khác Mythos ở đâu, giá rẻ hơn thật sự tới mức nào, bảng benchmark thắng và thua ở chỗ nào, vụ hình thức hóa chứng minh Định lý lớn Fermat trong 30 giờ thực chất là gì, và anh em dev hay người dùng gói trả phí nên hiểu đợt ra mắt này ra sao. Lưu ý trước: phần lớn số liệu dưới đây là do Anthropic tự công bố, chỉ một phần có đánh giá độc lập từ Artificial Analysis.
Một mô hình, hai cánh cửa: Fable cho số đông, Mythos cho tổ chức được xác minh
Điểm dễ gây nhầm nhất là Fable và Mythos không phải hai mô hình khác nhau. Anthropic nói rõ cả hai dùng chung một mô hình nền, chỉ khác lớp bảo vệ. Fable 5.2 có bộ phân loại an toàn chặn các tác vụ an ninh mạng rủi ro cao như kiểm thử xâm nhập, viết mã khai thác, cùng phần lớn tác vụ nghiên cứu sinh học, nhờ vậy mới được mở cho mọi người dùng. Khi một yêu cầu bị chặn, người dùng sẽ nhận câu trả lời từ Opus 4.8 (với an ninh mạng) hoặc Opus 5 (với sinh học) thay vì từ Fable.
Fable 5.2 và Mythos 5.2 ra mắt ngày 9/11, dùng chung một mô hình nền. Ảnh: Anthropic.
Mythos 5.2 thì gỡ bớt các giới hạn đó và chỉ dành cho tổ chức được duyệt qua Cyber Verification Program hoặc Life Sciences Verification Program. Khách hàng Claude Enterprise còn có thể dùng Mythos 5.2 gián tiếp qua Claude Security, công cụ quét lỗ hổng trong mã nguồn. Trên bài kiểm tra nội bộ CVE Rediscovery với 1.829 lỗ hổng đã công bố, chạy hồi tháng 10/2026, Anthropic cho biết Mythos 5.2 tìm được nhiều hơn Opus 5.5 10,2% và nhiều hơn Mythos 5.1 14,4%. Mozilla, đơn vị dùng Claude để gia cố Firefox suốt năm nay, nói Mythos 5.2 tăng gần gấp đôi các chỉ số phát hiện lỗ hổng so với Mythos 5.1.
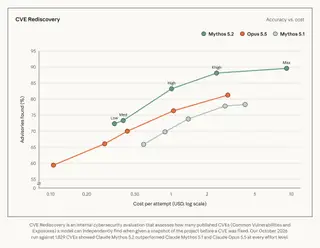
Biểu đồ CVE Rediscovery: Mythos 5.2 (xanh) tìm được nhiều lỗ hổng hơn Opus 5.5 và Mythos 5.1 ở mọi mức effort. Biểu đồ: Anthropic.
Với người dùng thường, tin tốt là Fable 5.2 ít “chặn oan” hơn: thử nghiệm sớm trên claude.ai, Claude Code và Cowork cho thấy số lần bị chặn giảm khoảng 55% so với Fable 5.1, cụ thể khoảng 60% với an ninh mạng và 40% với sinh học. Ở bài kiểm tra cố tình để lộ thông tin đăng nhập và file bên ngoài sandbox với hơn 1.800 kịch bản, Mythos 5.2 dùng tới chúng trong 3,1% trường hợp, gần bằng Opus 5.5 (3,3%) và giảm mạnh so với 21% của Mythos 5.1. Anthropic cũng thừa nhận mô hình mới hay nghi ngờ rằng mình đang bị kiểm tra hơn các bản trước, khiến việc đánh giá an toàn khó hơn.
Giá giảm 20% trên bảng, nhưng hóa đơn thật nằm ở mức effort
Trên bảng giá API, Fable 5.2 và Mythos 5.2 cùng có giá 8 USD mỗi triệu token đầu vào và 40 USD mỗi triệu token đầu ra, giảm từ 10 USD và 50 USD của thế hệ 5.1, tức đúng 20%. Giá đọc cache cũng giảm từ 0,25 xuống 0,20 USD mỗi triệu token. Ngữ cảnh là 1 triệu token, mỗi lần trả lời tối đa 128.000 token. Có thêm chế độ fast mode tăng tốc sinh token tới 2,5 lần với giá gấp đôi, 16 USD và 80 USD. Dù đã giảm, Fable vẫn đắt gấp đôi Opus 5.5 vốn có giá 4 USD và 20 USD.
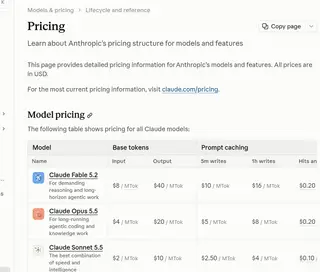
Bảng giá API: Fable 5.2 là 8 USD/40 USD mỗi triệu token, gấp đôi Opus 5.5. Ảnh chụp màn hình: Claude Platform Docs / Anthropic.
Nhưng giá theo token chỉ là một nửa câu chuyện, vì Fable có năm mức effort, mức càng cao thì mô hình càng nghĩ lâu và càng tốn token. VentureBeat dẫn system card cho thấy trên bài FrontierCode 2.0, Fable 5.2 ở mức High đạt 45,3% với chi phí trung bình 6,72 USD mỗi tác vụ, gần bằng điểm tốt nhất 45,5% của Opus 5.5 ở mức Max vốn tốn 12,82 USD. Đẩy lên Xhigh thì Fable đạt 49,1%, cao nhất trong các mô hình đã phát hành mà Anthropic thử, nhưng chi phí lên 14,19 USD. Còn ở mức Max, chi phí lên tới 44,70 USD mà điểm lại thấp hơn mức Xhigh.
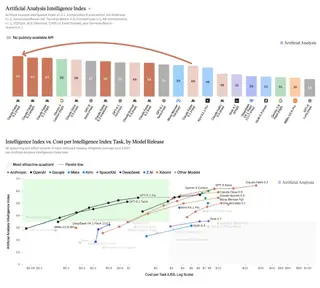
Chỉ số Intelligence Index và chi phí mỗi tác vụ của các mô hình theo Artificial Analysis. Biểu đồ: Artificial Analysis (qua The Decoder).
Đánh giá độc lập của Artificial Analysis cũng cho thấy điều tương tự. Ở mức cao nhất, Fable 5.2 đứng đầu Intelligence Index v5 với 65 điểm, nhưng chi phí trung bình 26,50 USD mỗi tác vụ, gấp khoảng 2,6 lần Opus 5.5. Ở các mức High và Xhigh, nó vẫn đạt 62 điểm, cao hơn mọi mô hình khác ở bất kỳ mức nào, trong khi chỉ dùng khoảng 98.000 token đầu ra mỗi tác vụ so với 173.000 của Opus 5.5 ở mức Max. Nói gọn: chọn đúng mức effort thì Fable có thể rẻ hơn Opus trên mỗi việc, chọn sai thì hóa đơn đội lên rất nhanh.
Benchmark: dẫn gần hết bảng, nhưng không thắng tuyệt đối
Trong bảng so sánh Anthropic công bố, Fable 5.2 vượt Opus 5.5, GPT-6 Astra và Gemini 4 Carbon ở phần lớn hạng mục. Trên FrontierSWE v2, nó đạt 69,9% so với 65,5% của GPT-6 Astra và 61,2% của Gemini 4 Carbon. Ở Humanity’s Last Exam có dùng công cụ là 74,2% so với 57,2% của GPT-6 Astra, còn bài dùng máy tính OSWorld 2.1 (bộ offline, tính điểm từng phần) là 89,3%. Mức nhảy lớn nhất nằm ở Remote Labor Index, từ 17,9% của Fable 5.1 lên 41,3%.
Nhưng có vài chỗ đáng để ý. Gemini 4 Carbon vẫn thắng bài tự động hóa quy trình doanh nghiệp AutomationBench (53,9% so với 51,4%), còn Opus 5.5 nhỉnh hơn ở điểm Elo của AA-Briefcase (1.800 so với 1.785). Theo Artificial Analysis, ở Terminal-Bench 4.0 Fable 5.2 chỉ đạt 60%, ngang Opus 5.5 và xếp sau Kimi K3.1 Pro, Gemini 4 Carbon lẫn Sonnet 5.5. Thêm nữa, Gemini 4 Carbon tới ngày 9/11 vẫn chỉ mở giới hạn, nên phép so này chưa hẳn đặt các bên vào cùng điều kiện người mua.
Fable 5.2 dẫn phần lớn bảng benchmark do Anthropic công bố, nhưng vẫn thua ở vài hạng mục. Ảnh: Anthropic (qua The Decoder).
Về lập trình thực tế, Anthropic kể vài ví dụ nội bộ. Một nhóm agent chạy bản Fable 5.2 trước khi phát hành đã chuyển một dịch vụ quan trọng từ Python sang Rust, giúp nó khởi động nhanh hơn khoảng 26 lần. Một kỹ sư khác giao cho Fable 5.2 viết hệ điều hành thử nghiệm từ một thư mục trống: mô hình điều phối hơn 1.000 subagent chạy liên tục 8 ngày, cho ra hệ điều hành khởi động được trên laptop, có driver ổ đĩa, bàn phím, mạng, lưu trữ file, cửa sổ, màn hình đăng nhập và trình cài đặt. Đây là demo do hãng chọn, chưa phải kiểm chứng độc lập.
Hệ điều hành do hơn 1.000 subagent Fable 5.2 viết trong 8 ngày chạy trên laptop, có sẵn khung Claude tích hợp; ảnh trích từ video demo. Ảnh: Anthropic.
Fermat trong 30 giờ: đây là kiểm chứng, không phải chứng minh mới
Câu chuyện gây chú ý nhất là việc hình thức hóa chứng minh Định lý lớn Fermat. Cần hiểu đúng: Fable 5.2 không tự tìm ra chứng minh mới. Chứng minh đúng đầu tiên do Andrew Wiles công bố năm 1995, còn “hình thức hóa” là dịch toàn bộ lập luận đó sang ngôn ngữ Lean để máy tính kiểm từng bước, loại bỏ khả năng có lỗ hổng mà người đọc bỏ sót.
Hồi tháng 9, Anthropic đã công bố lần hình thức hóa đầu tiên, do một bản Claude nghiên cứu chưa phát hành làm trong 11 ngày, cần harness xây riêng và hướng dẫn của một nhà nghiên cứu. Lần đó Claude viết 13 triệu dòng Lean và dùng 29.500 định lý trung gian trong chứng minh cuối. Lần này, khoảng 1.000 agent Fable 5.2 làm xong toàn bộ trong 30 giờ với rất ít can thiệp của con người, không dùng tài liệu toán tham khảo mà chỉ có danh sách các mệnh đề trung gian để chấm tiến độ.
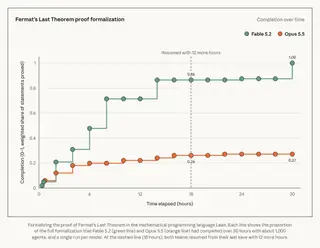
Tiến độ hình thức hóa Fermat: Fable 5.2 (xanh) đạt 100% sau 30 giờ, Opus 5.5 (cam) dừng ở khoảng 27%. Biểu đồ: Anthropic.
Fable 5.2 chỉ cần khoảng một phần ba số token hành động so với lần đầu và cho ra chứng minh ngắn hơn bảy lần. Với cùng cấu hình 1.000 agent, Opus 5.5 chỉ hoàn thành 26% sau 18 giờ và gần như không tiến thêm khi chạy tới giờ thứ 30. Biểu đồ cho thấy ở mốc 18 giờ Fable đã đạt 86%, sau đó cả hai được chạy tiếp từ bản lưu thêm 12 giờ. Mỗi mô hình chỉ chạy một lần, nên đây là thí nghiệm trình diễn hơn là phép đo có ý nghĩa thống kê.

Sơ đồ các nhánh định lý con (Mazur, Ribet, Wiles) trong lần hình thức hóa Fermat đầu tiên của Claude, công bố hồi tháng 9. Ảnh: Anthropic.
Mạch điện, protein và robot: AI bắt đầu chạm vào thế giới vật lý
Anthropic giao cho Fable 5.2 một prompt dài đúng một đoạn để thiết kế ba thiết bị điện tử hoàn chỉnh: một hub trợ lý giọng nói tại nhà, một speakerphone USB và một thú ảo cầm tay. Mô hình tự viết thông số, chọn linh kiện có bán ở các nhà phân phối Mỹ, đi mạch bo 4 lớp, dựng vỏ in 3D bằng CAD và viết phần mềm. Mỗi bo mạch sẵn sàng sản xuất trong chưa tới một ngày, và sau khi công ty Diode sản xuất bo, cả ba thiết bị đều chạy mà không cần sửa gì về điện.

Ba thiết bị Fable 5.2 tự thiết kế: thú ảo chạy pin, hub trợ lý giọng nói và speakerphone USB. Ảnh: Anthropic.
Trên BenchCAD 2.1 (thiết kế phần cứng, có công cụ), Fable 5.2 ở mức Max đạt 83,5 điểm, so với 65,3 của Opus 5.5 và 44,4 của Fable 5.1. Với robot, ở RoboDojo Sim, bài điều khiển cánh tay robot đôi mô phỏng qua hình ảnh camera, Fable 5.2 đạt 64,9%, hơn gấp đôi GPT-6 Astra (29,8%) và Fable 5.1 (27,6%) trong các lần chạy nội bộ của Anthropic. Hãng cũng chiếu video robot do Fable 5.2 điều khiển giải khối xếp hình, vặn nắp chai và vẽ tranh.

Hai cánh tay robot do Fable 5.2 điều khiển trong video demo, với các việc như giải khối xếp hình. Ảnh: Anthropic.
Ở mảng sinh học, Mythos 5.2 tìm ra cách dự đoán cấu trúc của cả lớp vỏ capsid của virus AAV, loại vỏ protein dùng để đưa liệu pháp gen vào cơ thể, bằng cách chạy hai mô hình gấp protein mã nguồn mở trên các nhóm chuỗi chồng lấn rồi ghép lại dựa trên tính đối xứng. Trong thử nghiệm, phương pháp này mô hình hóa chính xác 28 trên 34 capsid. Ngoài ra, Fable 5.2 còn giải được hai bài toán mở trong vật lý lỗ đen, với kết quả đăng dạng preprint.

Bề mặt vỏ capsid virus với các chuỗi protein, minh họa cho phương pháp dự đoán cấu trúc của Mythos 5.2. Ảnh: Anthropic.
Người dùng và dev nên hiểu đợt ra mắt này thế nào?
Fable 5.2 có ngay từ 9/11 trên mọi nền tảng, kể cả AWS, Google Cloud và Microsoft Azure. Với người dùng gói trả phí, riêng tuần này các gói có Fable được cộng thêm từ một đến ba lần reset Fable tùy thời gian đăng ký, và với gói Pro cùng ghế standard của gói Team, Fable được dùng tối đa 50% hạn mức hằng tuần. Dù vậy, Anthropic khuyên bắt đầu với Opus 5.5 cho phần lớn việc lập trình và công việc tri thức, chỉ chuyển lên Fable khi gặp bài thật khó. Fable còn có thể làm “Advisor” để Haiku, Sonnet hay Opus hỏi ý kiến, hoặc làm “Orchestrator” giao việc dễ cho mô hình nhỏ hơn.

Trang tài liệu của Fable 5.2: model ID claude-fable-5-2, ngữ cảnh 1 triệu token, đầu ra tối đa 128.000 token. Ảnh chụp màn hình: Claude Platform Docs / Anthropic.
Với dev, có vài ràng buộc cần biết trước khi đổi model ID sang claude-fable-5-2. Theo hướng dẫn chuyển đổi, cả Fable 5.2 lẫn Mythos 5.2 yêu cầu lưu dữ liệu 30 ngày để giám sát an toàn và không dùng được với thỏa thuận không lưu dữ liệu (ZDR) trừ khi Anthropic cho phép riêng. Điền trước (prefill) câu trả lời của trợ lý hay tắt chế độ suy nghĩ đều trả lỗi 400. Mức effort mặc định trên API là High, trong khi app Claude và Claude Code mặc định Medium. Fable 5.2 cũng có rate limit riêng, tách khỏi hạn mức chung của Fable 5.1 và Fable 5.

Các thiết lập dev cần lưu ý khi chuyển sang Fable 5.2, từ lỗi 400 khi prefill tới yêu cầu lưu dữ liệu 30 ngày. Ảnh chụp màn hình: Claude Platform Docs / Anthropic.
Tóm lại, Fable 5.2 không phải thứ để anh em bật lên trả lời email hay viết caption. Giá token giảm 20% là thật, nhưng giá trị của nó nằm ở những việc dài, khó và đo được kết quả như chuyển đổi codebase, kiểm chứng toán học hay thiết kế phần cứng, cùng với việc chọn đúng mức effort. Thêm một bối cảnh: theo CNBC, đây là lần đầu Anthropic tung mô hình frontier kể từ khi CEO Dario Amodei kêu gọi làm chậm nhịp phát triển AI hồi tháng 9, và nó đến ngay trước thương vụ IPO mà CNBC cho biết có thể diễn ra sớm nhất là tuần sau.
Nguồn: Anthropic , MacRumors , CNBC , VentureBeat , The Decoder
Mình cũng có chém gió công nghệ ở Facebook này: https://www.facebook.com/trananhtu57/