Robot học nghề từ video người thật: từ GR00T N1 năm 2025 đến GR00T 2
Muốn dạy robot lắp một món đồ chơi, cách phổ biến lâu nay là cho người điều khiển từ xa: đeo thiết bị, lái từng khớp tay của robot hàng trăm lần rồi ghi lại cho nó bắt chước. Cách làm này chậm và tốn kém, và đổi sang robot khác thì phải thu dữ liệu lại.
Muốn dạy robot lắp một món đồ chơi, cách phổ biến lâu nay là cho người điều khiển từ xa: đeo thiết bị, lái từng khớp tay của robot hàng trăm lần rồi ghi lại cho nó bắt chước. Cách làm này chậm và tốn kém, và đổi sang robot khác thì phải thu dữ liệu lại.
Tuần này, tại hội nghị Conference on Robot Learning (CoRL) ở Austin, Texas, NVIDIA giới thiệu GR00T 2, model giúp robot học kỹ năng mới từ video người làm việc. Trong một số thử nghiệm NVIDIA công bố, robot làm được những việc nó chưa từng được dạy trực tiếp, chỉ nhờ dữ liệu từ người.
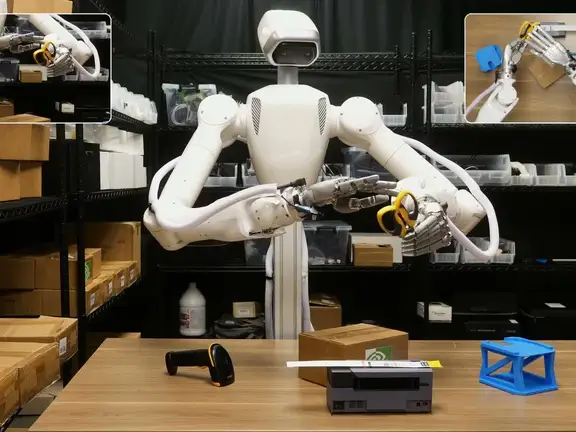
Robot Dexter (thân Tianji, hai bàn tay Sharpa) dùng kéo cắt nhãn vận chuyển trong video demo của NVIDIA. Ảnh: NVIDIA
Project GR00T được Jensen Huang công bố tại GTC tháng 3/2024, với mục tiêu làm một model nền tảng chung cho robot hình người. Tại GTC tháng 3/2025, NVIDIA ra mắt Isaac GR00T N1, model mở cho humanoid với khoảng 2 tỉ tham số, sau đó là các bản nâng cấp trong dòng N1.
GR00T 2 đổi cách tiếp cận: NVIDIA gọi nó là "world action model", tức model vừa dự đoán thế giới sẽ thay đổi thế nào, vừa đưa ra hành động. Thay vì chỉ học thuộc động tác, nó học cả việc đồ vật sẽ phản ứng ra sao khi bị tác động.
Humanoid Unitree G1, một trong các robot được dùng trong thử nghiệm GR00T 2. Ảnh: Sayanesy, CC0, Wikimedia Commons
World action model: robot "tưởng tượng" trước khi làm
Cách GR00T 2 làm việc giống một người thợ hình dung trước khi vặn ốc: tay sẽ đi đường nào, con ốc sẽ xoay ra sao, rồi mới làm thật. Model đọc đoạn hình ảnh gần nhất từ camera của robot cùng câu lệnh và trạng thái hiện tại, rồi dùng một diffusion transformer để tạo ra cùng lúc hai thứ: đoạn hình ảnh tương lai mà nó dự kiến sẽ thấy, và chuỗi lệnh điều khiển để robot đi tới kết quả đó.
Dữ liệu huấn luyện gồm 402.730 giờ video góc nhìn thứ nhất của người đang làm việc, 10.184 giờ làm mẫu bằng tay kẹp cầm tay trên 2.897 nhiệm vụ, và 23.500 giờ điều khiển robot thật. Trong đó, 100.000 giờ video người được NVIDIA mở công khai trên Hugging Face.
GR00T 2 học kỹ năng mới qua ba bước: xem, tưởng tượng, làm. Ảnh: Sơ đồ tự vẽ theo mô tả của NVIDIA
Công cụ tái tạo chuyển động bàn tay 3D từ video góc nhìn thứ nhất. Ảnh: NVIDIA
Kỹ năng của người, tay của robot
Điểm đáng chú ý nhất là khả năng chuyển kỹ năng giữa các "cơ thể" khác nhau. Theo NVIDIA, một robot hai bàn tay năm ngón chỉ được xem người lót giấy lọc vào phễu rồi làm ướt giấy đã tự làm được trong 65% số lần thử. Một cánh tay YAM chỉ học từ dữ liệu tay kẹp cầm tay, vốn khác với tay kẹp của chính nó, đã lắp trọn chiếc xe tải đồ chơi trong 60% số lần thử, một việc kéo dài tới 4 phút.
Trên 50 nhiệm vụ mà robot đích chưa từng được dạy, GR00T 2 thành công trung bình 40% số lần thử khi chưa có dữ liệu robot nào, và làm được ít nhất một lần ở 40/50 nhiệm vụ. Cho thêm 1 lần làm mẫu mỗi nhiệm vụ, tỉ lệ lên 71%; với 5 lần làm mẫu, tức chưa tới 3 phút dữ liệu robot, tỉ lệ lên 95%. Mỗi lần thích nghi là một lần fine-tune LoRA khoảng 30 phút trên một card RTX 5090. Đây là số liệu NVIDIA tự công bố trên bộ nhiệm vụ của hãng, chưa có kiểm chứng độc lập.
Khi được một model lý luận điều phối qua API, chia việc lớn thành từng bước và gọi GR00T 2 làm từng thao tác, cánh tay YAM hoàn thành từ 97 trên 100 lần lắp ráp liên tiếp trở lên với mỗi món đồ chơi trong ba món, tự gỡ khi bị kẹt hay mắc lỗi.
Ambi Robotics thử nghiệm cách dùng agent nối các kỹ năng robot thành chương trình. Ảnh: NVIDIA
Luyện trong mô phỏng trước khi ra xưởng
Song song với GR00T 2, NVIDIA cập nhật Isaac Lab 3.0, khung huấn luyện robot trong mô phỏng mã mở, với engine vật lý Newton mô phỏng được cả vật mềm, biến dạng. Theo NVIDIA, trong một bài đo thao tác khéo léo dựa trên hình ảnh, Isaac Lab 3.0 với Newton cho tốc độ huấn luyện cao gấp 2,5 lần Isaac Lab 2.3 dùng PhysX.
Hãng cũng giới thiệu hai bộ benchmark mở DexBench và VABAR để đo độ khéo léo và khả năng thích nghi của robot trong tác vụ công nghiệp. Bản GR00T 2 Turbo nhỏ hơn, khoảng 2 tỉ tham số, mỗi lần dự đoán mất 124 mili giây ngay trên máy tính Jetson Thor gắn trong humanoid Unitree G1.
Mô phỏng Newton: quả dâu tây biến dạng dưới lực kẹp của robot. Ảnh: NVIDIA
Nhiều robot luyện tập song song trong Isaac Lab. Ảnh: NVIDIA
Trang nghiên cứu của NVIDIA ghi mã nguồn GR00T 2 sẽ có vào tháng 12/2026; điều khoản giấy phép cụ thể chưa được công bố.
Ai đang thử, và còn khoảng cách nào
NVIDIA cho biết Foxconn đang áp dụng GR00T 2 cho tự động hóa nhà máy sản xuất máy chủ, Nexuni thử robot xử lý đồ giặt, còn Siemens đánh giá model cho các ứng dụng công nghiệp. Với các nhóm nghiên cứu robot nhỏ, kể cả ở Việt Nam, điểm đáng chú ý là phần mở: 100.000 giờ video người đã công khai, mã nguồn sẽ ra vào tháng 12, và Isaac Lab là mã mở.
Dù vậy, khoảng cách từ phòng thí nghiệm tới nhà xưởng vẫn lớn: 95% thành công trong thử nghiệm của hãng chưa phải là độ tin cậy cần có trên dây chuyền, nơi một lỗi trong 20 lần cũng đủ gây gián đoạn.
GR00T 2 đáng chú ý không phải vì to hơn, mà vì cách học gần với con người hơn: xem người khác làm, hình dung kết quả rồi tự làm thử. Nếu kết quả này giữ được ngoài phòng thí nghiệm, video quay người thợ lành nghề sẽ trở thành nguồn dữ liệu dạy robot rẻ và dồi dào nhất. Anh em nghĩ sao: nếu chỉ cần quay video là dạy được robot, anh em muốn dạy robot làm việc gì đầu tiên?
Nguồn: NVIDIA Blog – robotics and simulation advancements at CoRL , NVIDIA Research – GR00T 2 , NVIDIA Newsroom – Project GR00T (GTC 2024) , NVIDIA Newsroom – Isaac GR00T N1 (GTC 2025) , arXiv – GR00T N1