Model mở 1.000 tỉ tham số: từ Mistral 7B năm 2023 đến Le Chonk của Mistral
Ngày 29/10/2026, hãng AI Pháp Mistral AI công bố toàn bộ trọng số của Mistral Large 4, model lớn nhất của hãng, với biệt danh do chính hãng đặt: " Le Chonk ". Đây là model 1.000 tỉ tham số mà Mistral gọi là model mở tốt nhất hiện nay cho viết code, và ai cũng có thể tải về để chạy trên hạ tầng của mình.
Ngày 29/10/2026, hãng AI Pháp Mistral AI công bố toàn bộ trọng số của Mistral Large 4, model lớn nhất của hãng, với biệt danh do chính hãng đặt: " Le Chonk ". Đây là model 1.000 tỉ tham số mà Mistral gọi là model mở tốt nhất hiện nay cho viết code, và ai cũng có thể tải về để chạy trên hạ tầng của mình.
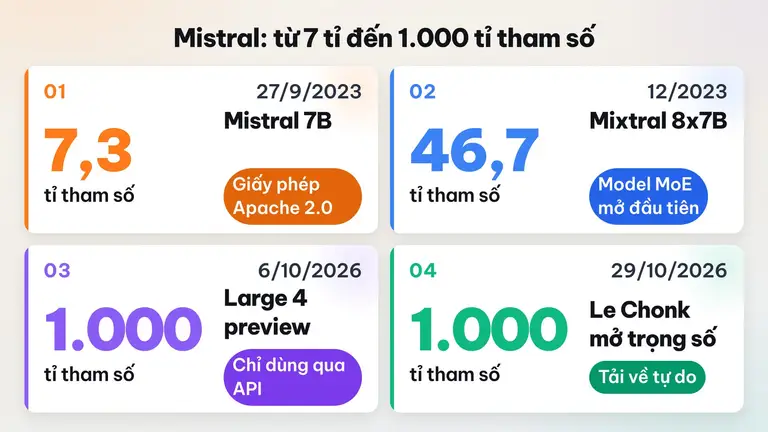
Từ Mistral 7B năm 2023 tới Le Chonk mở trọng số năm 2026. Ảnh: Sơ đồ tự vẽ theo dữ liệu Mistral AI
Từ 7 tỉ đến 1.000 tỉ: ba năm của Mistral
Mistral AI thành lập tháng 4/2023 tại Paris, bởi ba nhà nghiên cứu từng làm ở DeepMind và Meta. Ngày 27/9/2023, hãng ra model đầu tiên, Mistral 7B: 7,3 tỉ tham số, giấy phép Apache 2.0, dùng thoải mái kể cả thương mại. Theo hãng, model nhỏ này vượt Llama 2 13B trên mọi bài kiểm tra họ đo.
Tháng 12/2023, hãng ra Mixtral 8x7B, model "chuyên gia hỗn hợp" mở: 46,7 tỉ tham số tổng, mỗi lần chỉ 12,9 tỉ tham số hoạt động.
Ngày 6/10/2026, Mistral mở bản xem trước của Large 4 qua API và hứa mở trọng số trước cuối tháng. Ba tuần sau, hãng giữ lời.
Cơ chế: 128 chuyên gia, mỗi lần chỉ 4 người làm việc
Le Chonk là model Mixture-of-Experts. Thay vì một mạng nơ-ron khổng lồ làm mọi việc, model gồm 128 "chuyên gia" nhỏ. Bộ định tuyến (router) đọc từng token, chọn 4 chuyên gia phù hợp nhất, cộng thêm 1 chuyên gia chung luôn tham gia, rồi gộp kết quả lại.
Nhờ vậy, model có khoảng 1.000 tỉ tham số nhưng mỗi token chỉ chạy khoảng 49 tỉ tham số (52 tỉ nếu tính cả lớp embedding và lớp đầu ra). Chi phí tính toán mỗi câu trả lời gần với một model vài chục tỉ tham số, trong khi lượng "kiến thức" chứa trong model lớn hơn nhiều.
Router chọn 4 trong 128 chuyên gia cho mỗi token. Ảnh: Sơ đồ tự vẽ theo model card trên Hugging Face
Le Chonk nhận cả chữ lẫn ảnh, thông thạo hơn 160 ngôn ngữ, ngữ cảnh tới 1 triệu token và có ba mức suy luận: thấp, vừa, cao (mặc định là cao).
Giỏi tới đâu, và điểm nào cần dè chừng
Theo số liệu Mistral công bố, Le Chonk đạt 19,7% trên FrontierCode 2.0, dẫn đầu nhóm model mở. Trên Terminal-Bench 4.0, điểm tăng 13 điểm phần trăm lên 41% so với bản xem trước, trong khi số token đầu ra giảm 30%.
Trên Coding Agent Index của Artificial Analysis, model đạt 48%, ngang GLM-5.3 nhưng dùng ít hơn 47% token mỗi nhiệm vụ. Ở mảng bảo mật, model đạt 51% trên Cyber Index, từ chối trung bình 96,6% yêu cầu độc hại và chống được 97,1% đòn tấn công trong bài kiểm tra an ninh agent B3.
Điểm số do Mistral công bố, mỗi bài kiểm tra có thang đo riêng. Ảnh: Biểu đồ tự vẽ theo dữ liệu Mistral AI
Trong các bài so sánh mù của Surge Code, người chấm thích code của Le Chonk hơn GLM-5.3, Kimi K3 và DeepSeek V4.1 Flash, chỉ xếp sau Claude Opus 5.5.
Cần nói rõ: gần như mọi con số trên đều do Mistral tự công bố. Trên chỉ số tổng hợp Intelligence Index v5, Le Chonk đạt 26 điểm, cao nhất trong các model mở phương Tây, nhưng chính Mistral thừa nhận các model mở hàng đầu của Trung Quốc vẫn điểm cao hơn.
Mở trọng số nghĩa là gì, và cái giá phần cứng
"Mở trọng số" nghĩa là Mistral công bố toàn bộ tham số đã huấn luyện trên Hugging Face. Giấy phép đi kèm là Mistral Ecosystem Open-Weight License, bản sửa đổi của giấy phép MIT: được dùng, sửa, fine-tune và thương mại hóa, chỉ một điều kiện là doanh nghiệp kinh doanh dịch vụ cho thuê model (Model-as-a-Service) phải xin giấy phép thương mại riêng.
Nhưng tải về không có nghĩa là chạy được trên máy cá nhân. Với 1.000 tỉ tham số, riêng trọng số ở định dạng 8 bit đã vào khoảng 1 TB (ước tính). Hướng dẫn chạy chính thức dùng cụm 8 GPU. Mistral huấn luyện model trên 3.800 GPU NVIDIA Grace Blackwell tại trung tâm dữ liệu của hãng ở châu Âu .
Chạy model 1.000 tỉ tham số cần cụm GPU của trung tâm dữ liệu, không phải laptop. Ảnh: NERSC, Wikimedia Commons (CC0)
Với người dùng cá nhân, thực tế hơn là dùng API: 0,70 USD cho mỗi triệu token đầu vào, 0,07 USD cho token đầu vào đã lưu đệm và 2,10 USD cho mỗi triệu token đầu ra. Model cũng có trên Mistral Studio, OpenRouter, Microsoft Foundry và NVIDIA NIM.
Chủ quyền AI: vì sao châu Âu cần một "Le Chonk"
Mistral gọi Large 4 là nền tảng cho "AI có chủ quyền": tổ chức có thể kiểm tra, tùy biến và chạy model trên hạ tầng của mình mà không phụ thuộc API của hãng khác. Trang công bố trích lời ủng hộ từ ABN AMRO, Crédit Agricole, La Banque Postale, Orange Cyberdefense, cơ quan an ninh mạng châu Âu ENISA và nhiều hãng bảo mật như Cisco, Cloudflare, CrowdStrike.
Danh sách đối tác Mistral đưa ra khi mở trọng số Large 4. Ảnh: Mistral AI
Với nhóm phát triển ở Việt Nam, ý nghĩa thực tế nằm ở hai hướng. Một là dùng API giá thấp để làm trợ lý viết code hay rà soát lỗ hổng. Hai là đơn vị có hạ tầng đủ mạnh có thể tải trọng số về, fine-tune cho tiếng Việt hoặc nghiệp vụ riêng mà dữ liệu không rời máy chủ của mình.
Le Chonk không phải model mạnh nhất thế giới: theo chính số liệu Mistral đưa ra, model mở của Trung Quốc vẫn dẫn trên chỉ số tổng hợp, còn ở bài so code mù nó xếp sau Claude Opus 5.5. Nhưng đây là model lớn nhất, mạnh nhất Mistral từng làm, và hãng vẫn chọn mở trọng số thay vì giữ riêng.
Ba năm trước, Mistral bắt đầu bằng model 7 tỉ tham số chạy vừa trên một card đồ họa; nay model của hãng nặng 1.000 tỉ tham số nhưng vẫn mở cho mọi người. Nếu có một model mở cỡ này được fine-tune riêng cho tiếng Việt, anh em muốn nó làm việc gì đầu tiên?
Mistral AI - Mistral Large 4 (Le Chonk) is now open weight Mistral AI - Introducing Mistral Large 4 (6/10/2026) Hugging Face - Mistral-Large-4-1T-A52B Mistral AI - Mistral 7B arXiv - Mixtral of Experts