Chatbot AI tạo câu trả lời như thế nào: đoán từng token một, không tra cứu sẵn
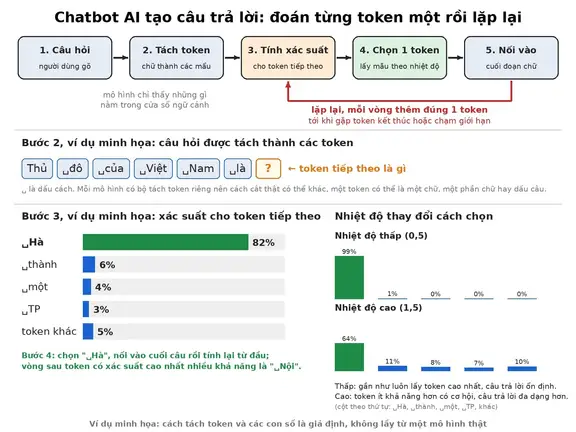
Chatbot như ChatGPT, Gemini, Grok hay Claude không lấy câu trả lời soạn sẵn ra từ một kho nào cả. Mô hình ngôn ngữ lớn bên dưới cắt câu hỏi thành các mẩu chữ gọi là token, tính xác suất cho mẩu chữ có thể đứng tiếp theo, chọn một mẩu, nối vào rồi lặp lại cho tới khi xong câu trả lời. Vì vậy câu trả lời hiện ra dần từng chữ, và chatbot đôi khi nói sai rất trôi chảy. Web Summit 2026 ở Lisbon (9–12/11) cũng có hẳn chuỗi phiên AI Summit.
Chatbot như ChatGPT, Gemini, Grok hay Claude không lấy câu trả lời soạn sẵn ra từ một kho nào cả. Mô hình ngôn ngữ lớn bên dưới cắt câu hỏi thành các mẩu chữ gọi là token, tính xác suất cho mẩu chữ có thể đứng tiếp theo, chọn một mẩu, nối vào rồi lặp lại cho tới khi xong câu trả lời. Vì vậy câu trả lời hiện ra dần từng chữ, và chatbot đôi khi nói sai rất trôi chảy. Web Summit 2026 ở Lisbon (9–12/11) cũng có hẳn chuỗi phiên AI Summit.
Theo OpenAI, token có thể là một ký tự, một phần của từ, cả một từ hoặc một dấu câu. Với tiếng Anh, 100 token khoảng 75 từ; ngôn ngữ khác có tỷ lệ khác và mỗi mô hình cắt chữ một kiểu. Mỗi token được gán một mã số để mô hình tính toán.
Sơ đồ tự vẽ: vòng lặp sinh câu trả lời từng token một; cách tách token và các con số xác suất chỉ là ví dụ minh họa
Mô hình chỉ đoán token tiếp theo
Theo Wikipedia, các mô hình GPT được huấn luyện trước để đoán từ tiếp theo trên lượng văn bản khổng lồ. Khi trả lời, mô hình nhìn đoạn chữ đang có rồi cho ra xác suất của mọi token trong bộ từ vựng. Cách mô hình học ra các con số bên trong đã có trong bài Trí tuệ nhân tạo học thế nào ; bài này nói về lúc mô hình đã học xong và đem ra dùng.
Các mô hình này thường dựa trên kiến trúc transformer, ra đời năm 2017 trong bài báo Attention Is All You Need của tám nhà nghiên cứu tại Google. Cơ chế attention giúp mô hình xác định token nào liên quan tới token nào.
Kiến trúc transformer gốc trong bài báo Attention Is All You Need (2017); dòng GPT chỉ dùng phần giải mã bên phải, trên cùng là lớp Softmax cho ra xác suất token tiếp theo. Ảnh: Google qua Wikimedia Commons, CC BY-SA 4.0
Chọn một token: nhiệt độ, top-K và top-P
Tài liệu Vertex AI của Google mô tả ba thông số chọn token:
Nhiệt độ (temperature) chỉnh mức ngẫu nhiên: thấp cho câu trả lời ổn định, cao cho kết quả đa dạng hơn. Ở mức 0, token xác suất cao nhất luôn được chọn, câu trả lời gần như cố định. Top-K chỉ chọn trong K token cao nhất; top-K bằng 1 là luôn lấy token cao nhất. Top-P cộng dồn xác suất từ cao xuống tới ngưỡng P: ba token 0,3, 0,2 và 0,1 với top-P 0,5 thì chỉ hai token đầu được xét.
Token vừa chọn được nối vào cuối, đoạn chữ mới lại đưa vào mô hình để đoán tiếp, cho tới khi gặp token kết thúc hoặc chạm giới hạn đầu ra. Vì có bước lấy mẫu, hỏi lại cùng câu có thể nhận câu trả lời khác. Mô hình suy luận còn sinh token suy luận nội bộ không hiển thị, theo OpenAI.
Cửa sổ ngữ cảnh là trí nhớ tạm
Anthropic định nghĩa cửa sổ ngữ cảnh là toàn bộ văn bản mô hình tham chiếu được khi trả lời, gồm cả câu trả lời, giống trí nhớ làm việc và khác với dữ liệu huấn luyện. Cửa sổ của Claude lên tới 1 triệu token tùy mô hình, nhưng càng nhiều token thì độ chính xác càng giảm. Giao diện chat có thể bỏ dần phần cũ nhất khi hội thoại dài ra.
Hình trong bài báo Attention Is All You Need: attention nối chữ "its" với "Law" và "application" để biết "its" chỉ cái gì. Ảnh: Google qua Wikimedia Commons, CC BY-SA 4.0
OpenAI gọi ảo giác (hallucination) là phát biểu nghe hợp lý nhưng sai. Hỏi một chatbot phổ biến tên luận án tiến sĩ của Adam Tauman Kalai, đồng tác giả nghiên cứu, nó tự tin đưa ba đáp án đều sai. Theo OpenAI, lúc huấn luyện mô hình chỉ thấy văn bản trôi chảy, không có nhãn đúng sai; chính tả có quy luật nên ít lỗi, còn dữ kiện lẻ như ngày sinh một người thì không đoán được từ quy luật. Cách chấm điểm chỉ tính tỷ lệ đúng cũng khuyến khích mô hình đoán thay vì nói không biết.
Vì vậy nhiều chatbot được nối công cụ: theo Wikipedia, một chương trình riêng thấy cú pháp gọi công cụ trong chữ mô hình sinh ra thì chạy tìm kiếm hay đoạn mã, rồi đưa kết quả lại cho mô hình đọc. Truy xuất tài liệu (RAG) cũng giúp giảm bịa, nhưng câu trả lời vẫn được đoán từng token nên vẫn cần kiểm tra nguồn.
Mô hình vừa huấn luyện trước chỉ biết viết tiếp văn bản. Năm 2022, OpenAI giới thiệu InstructGPT: người gán nhãn viết câu trả lời mẫu và xếp hạng câu trả lời, một mô hình thưởng học cách chấm theo đó, rồi GPT-3 được tinh chỉnh bằng học tăng cường, gọi là RLHF. Người gán nhãn thích bản InstructGPT 1,3 tỷ tham số hơn GPT-3 175 tỷ tham số. ChatGPT là mô hình anh em của InstructGPT, tinh chỉnh cho hội thoại. Tinh chỉnh đổi cách chọn chữ, còn bên dưới vẫn là đoán token tiếp theo.
Nguồn: OpenAI Help: Understanding and counting tokens , Google Cloud Vertex AI: Adjust parameter values , Anthropic: Context windows , OpenAI: Why language models hallucinate , OpenAI: Aligning language models to follow instructions , Vaswani et al.: Attention Is All You Need , Wikipedia: Large language model , Web Summit: AI Summit