GPU Nvidia cũ hóa ra bị “phong ấn” cả đống sức mạnh AI, benchmark tăng tới 80% sau khi mở khóa
Các dự án cộng đồng đã gỡ giới hạn tính toán FP16/BF16 trên một số GPU RTX, giúp benchmark Tensor tăng mạnh nhưng game và tốc độ sinh token hầu như không đổi.
Các dự án cộng đồng đã gỡ giới hạn tính toán FP16/BF16 trên một số GPU RTX, giúp benchmark Tensor tăng mạnh nhưng game và tốc độ sinh token hầu như không đổi.
Các nhà phát triển vừa tìm ra cách gỡ giới hạn tốc độ tính toán AI trên một số GPU Nvidia RTX 20, 30 và 40 series thông qua lỗ hổng firmware. RTX 4090 có thể tăng gấp đôi tốc độ Tensor lý thuyết, trong khi RTX 3090 Ti cải thiện tới 80% ở một số phép nhân ma trận.
Tuy nhiên, mức tăng này không áp dụng cho toàn bộ GPU hay mọi phần mềm. Hiệu quả phụ thuộc vào loại phép tính, ứng dụng, giới hạn điện năng và từng mẫu card.
Khai thác firmware để mở khóa GPU
Theo Tom’s Hardware, Nvidia cấu hình một số GPU GeForce chạy phép tính FP16 hoặc BF16 có tích lũy FP32 ở tốc độ bằng một nửa chế độ tích lũy FP16. Giới hạn tương tự không xuất hiện trên một số GPU chuyên nghiệp.
FP16 và BF16 là các định dạng số thường dùng để tăng tốc AI, còn việc tích lũy bằng FP32 giúp duy trì độ chính xác. Trên những GPU GeForce bị ảnh hưởng, tốc độ phát lệnh cho dạng phép tính này bị giảm dù phần cứng vẫn có khả năng chạy nhanh hơn.
Dự án gpu-unlock nhắm tới RTX 30 series, còn gpu-unlock-ada mở rộng thử nghiệm sang RTX 40 series. Một dự án khác mang tên turing-unlock hỗ trợ một số card RTX 20.
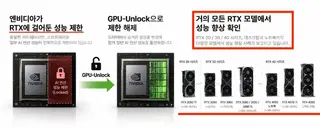
Các công cụ không ép xung hay bổ sung nhân xử lý mới. Chúng khai thác lỗi tràn bộ đệm trong firmware SEC2 Booter để thay đổi hai thanh ghi điều khiển tốc độ bên trong GPU. Card sau đó được khởi động lại trước khi trình điều khiển Nvidia được nạp.
Phiên bản Linux hoạt động dưới dạng mô-đun nhân hệ điều hành, không cần sửa trình điều khiển hoặc ghi đè vĩnh viễn VBIOS. Tuy vậy, quá trình cài đặt vẫn yêu cầu can thiệp sâu vào lúc khởi động máy và chưa phù hợp với người dùng phổ thông.
Kết quả đã được báo cáo trên RTX 3090 Ti, RTX 3090, RTX 3080, RTX 3070 và RTX 3060 12 GB. Với RTX 40 series, RTX 4090 được kiểm chứng rõ nhất; RTX 4090 D, RTX 4070 Ti Super và RTX 4060 Ti 16 GB vẫn ở trạng thái thử nghiệm. RTX 50 series chưa được hỗ trợ.
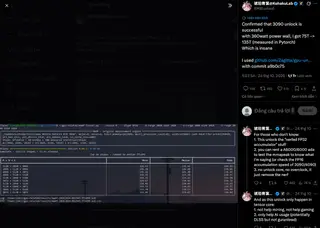
Gấp đôi tốc độ Tensor không có nghĩa ứng dụng nhanh gấp đôi
Trong thử nghiệm của gpu-unlock-ada, RTX 4090 tăng tốc độ Tensor FP16 từ 165,6 lên 331,6 TFLOPS. BF16 cũng tăng từ 165,5 lên 330,6 TFLOPS, tương đương gần gấp đôi.
Dù vậy, phép thử nhân ma trận cuBLAS thực tế trên cùng dòng GPU chỉ ghi nhận FP16 tăng khoảng 12-34%, còn BF16 tăng tối đa 20%. Nhóm phát triển lưu ý đây mới là kết quả trên một hệ thống, không đại diện cho mọi ứng dụng hoặc độ ổn định lâu dài.
RTX 3090 Ti được báo cáo tăng khoảng 35% với FP16, 80% với BF16 và 94% với TF32. Các thử nghiệm cộng đồng ghi nhận RTX 3090 tăng 25-67%, RTX 3080 10 GB tăng 70-73%, RTX 3070 tăng 73-81% và RTX 3060 12 GB tăng khoảng 80% trong benchmark BF16.
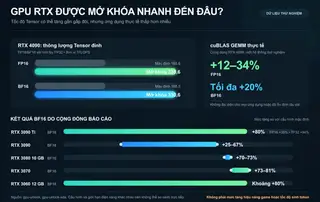
Những con số trên không thể so sánh trực tiếp vì được đo trên các hệ thống, mức điện năng và kích thước ma trận khác nhau. Khi card chạm giới hạn công suất, mức tăng thực tế có thể thấp hơn đáng kể.
Các tác vụ phụ thuộc nhiều vào phép nhân ma trận hưởng lợi rõ hơn. Tốc độ xử lý dữ liệu đầu vào của mô hình ngôn ngữ, thường gọi là prefill, được ghi nhận tăng khoảng 14-36% trên GPU Ampere. Một số tác vụ tạo ảnh và FlashAttention cũng chạy nhanh hơn.
Ngược lại, quá trình sinh từng token của LLM chủ yếu bị giới hạn bởi băng thông bộ nhớ nên gần như không đổi. Tác vụ INT8 ít được hưởng lợi và hiện chưa có benchmark độc lập nào chứng minh game tăng FPS sau khi mở khóa.
Các dự án vẫn mang tính thử nghiệm. Nhà phát triển cảnh báo thao tác có thể khiến hệ thống treo, không thể khởi động, làm hỏng dữ liệu hoặc thậm chí gây hư hại phần cứng. Nvidia cũng chưa phản hồi về các công cụ này, nên chưa đủ cơ sở khẳng định hãng cố tình khóa hiệu năng để buộc người dùng mua GPU chuyên nghiệp.