Giọng nói cũng là yếu tố nhận diện: Nhật đưa ra phán quyết đầu tiên về nhân bản giọng nói bằng AI
Từ tháng 7/2024 đến tháng 9/2025, một tài khoản TikTok ẩn danh ở Nhật, có khoảng 210.000 người theo dõi, đã đăng ít nhất 188 video về truyền thuyết đô thị và những câu chuyện kỳ bí. Mỗi video của tài khoản này đạt trung bình khoảng 1,47 triệu lượt xem, mang về 500.000 đến 750.000 yên mỗi tháng. Điểm chung của tất cả là giọng đọc: trầm, khàn, rất giống Kenjiro Tsuda, diễn viên lồng tiếng quen thuộc với anh em fan anime qua vai Kento Nanami trong Jujutsu Kaisen và Seto Kaiba trong Yu-Gi-Oh!. Chỉ là Tsuda chưa bao giờ đọc những video đó, giọng nói đó được tạo bằng AI .
Từ tháng 7/2024 đến tháng 9/2025, một tài khoản TikTok ẩn danh ở Nhật, có khoảng 210.000 người theo dõi, đã đăng ít nhất 188 video về truyền thuyết đô thị và những câu chuyện kỳ bí. Mỗi video của tài khoản này đạt trung bình khoảng 1,47 triệu lượt xem, mang về 500.000 đến 750.000 yên mỗi tháng. Điểm chung của tất cả là giọng đọc: trầm, khàn, rất giống Kenjiro Tsuda, diễn viên lồng tiếng quen thuộc với anh em fan anime qua vai Kento Nanami trong Jujutsu Kaisen và Seto Kaiba trong Yu-Gi-Oh!. Chỉ là Tsuda chưa bao giờ đọc những video đó, giọng nói đó được tạo bằng AI .
Ngày 30/9/2026 vừa rồi, Tòa án Quận Tokyo ra phán quyết trong vụ Tsuda kiện đơn vị vận hành TikTok. Trên thực tế thì đây là vụ kiện đầu tiên ở Nhật liên quan đến việc nhân bản giọng nói bằng AI. Thẩm phán chủ tọa Aya Takahashi kết luận rằng “giọng nói con người là biểu tượng cho nhân cách của một cá nhân, cũng như hình ảnh” và cá nhân mình nghĩ rằng câu này quan trọng hơn rất nhiều so với bản chất vụ kiện, vì nó là lần đầu tiên con người đặt giọng nói ngang hàng với gương mặt trong mắt pháp luật.
Bản quyền hình ảnh và tại sao giọng nói trước giờ được coi là ngoại lệ Nhật Bản có một khái niệm pháp lý gọi là “quyền công bố” (publicity right). Hiểu đơn giản, đây là quyền của người nổi tiếng được kiểm soát việc người khác dùng tên tuổi và hình ảnh của mình để kiếm tiền. Nếu một hãng in mặt ca sĩ lên bao bì sản phẩm mà không xin phép, họ vi phạm quyền này. Tòa án Tối cao Nhật đã công nhận quyền công bố từ năm 2012, trong vụ bộ đôi ca sĩ Pink Lady kiện một tạp chí dùng ảnh của họ chưa xin phép.
Vấn đề ở đây là giọng nói chưa bao giờ được gọi tên rõ ràng trong khung pháp lý đó. Hơn nữa, Nhật Bản cũng không có luật nào nói thẳng về “quyền giọng nói”. Suốt nhiều năm, điều này gần như không gây ra rắc rối gì. Muốn bắt chước giọng một người nổi tiếng, chúng ta chỉ cần một diễn viên bắt chước giọng giỏi, nhưng kết quả thì hiếm khi giống đến mức tạo ra sự nhầm lẫn thật sự. Tuy nhiên, AI thì khác, nó thay đổi hoàn toàn bài toán đó. Chỉ cần vài phút ghi âm, một mô hình có thể học được âm sắc, nhịp điệu và cách nhấn nhá của một người, rồi đọc bất kỳ văn bản nào bằng giọng đó. Giọng nói của một diễn viên lồng tiếng, thứ họ mất hàng chục năm để luyện và là nguồn thu nhập chính của họ, giờ có thể bị sao chép với chi phí gần bằng không. À, không hẳn là bằng không, anh em cũng sẽ tốn chi phí để trả cho cá công cụ AI.
Lập luận của Tik Tok: đó là giọng nam chung chung và tài khoản cũng đã vội xoá video Ngược lại, phía TikTok lập luận rằng giọng đọc trong các video chỉ là “một giọng nam chung chung”. Họ nói mô hình AI được huấn luyện từ giọng của một người bạn của chủ tài khoản, không phải từ giọng Tsuda. Lập luận này nghe có lý nếu xét theo cách AI hoạt động. Không ai có quyền sở hữu một “kiểu giọng” như trầm hay khàn, mà thực ra thì hàng triệu đàn ông có chất giọng trầm trầm này. Nếu mọi giọng trầm khàn đều bị coi là bắt chước Tsuda, thì luật sẽ trở nên vô lý.
Tuy nhiên, phía của Tsuda đâu để yên như vậy. Luật sư của ông đã đưa ra kết quả phân tích âm học và cho rằng giọng đọc trong video là sự bắt chước có chủ đích chất giọng “trầm và bóng” đặc trưng của ông. Ngoài ra, tòa không xem giọng nói chỉ là dữ liệu âm thanh vô chủ và việc dùng giọng nói của người khác mà không được phép có thể vi phạm quyền công bố khi mục đích là khai thác sức hút thương mại của giọng nói ấy.
TikTok lấp liếm đó là giọng chung chung, và tài khoản cũng đã xoá video trước khi Toà kịp xử
Mình thấy điểm mấu chốt nằm ở chữ “sức hút thương mại”. Tòa không nói ai có giọng giống Tsuda cũng vi phạm. Tòa nói rằng khi một người cố tình tạo ra giọng giống Tsuda để thu hút người xem và kiếm tiền, thì họ đang lấy đi thứ thuộc về Tsuda. Một tài khoản kiếm hàng trăm nghìn yên mỗi tháng từ một chất giọng quen tai với fan anime khó có thể nói đó là trùng hợp.
Có một chi tiết khiến phán quyết này mang tính biểu tượng nhiều hơn thực tế. Các bản tin mình đọc được chưa nói rõ mức bồi thường, nếu có, nhưng điều chắc chắn là toà sẽ bác bỏ yêu cầu gỡ bỏ video liên quan tới Tsudua, vì tài khoản và video đã bị gỡ từ trước, còn gì đâu để mà gỡ. Chi tiết này cho thấy một vấn đề pháp lý chắc chắc sẽ lặp đi lặp lại nhiều lần: tài khoản vi phạm có thể kiếm tiền trong hơn một năm, rồi biến mất khi bị kiện. Thời gian xử lý của toàn án thường khá chậm và nó đã đủ để bên bị đơn tẩu tán video, đồng thời mọc lên một tài khoản khác. Phán quyết của toà chỉ có giá trị tạo tiền lệ, nhưng nó không lấy lại được khoản tiền đã kiếm, cũng không ngăn được tài khoản tiếp theo thực hiện hành vi tương tự.
Ngoài ra, luật sư của Tsuda còn cáo buộc hành vi cạnh tranh không lành mạnh theo Luật Chống cạnh tranh không lành mạnh của Nhật. Luật này ra đời trước thời AI tạo giọng rất lâu, nên việc áp dụng nó cho giọng nói tổng hợp vẫn là câu hỏi pháp lý còn mở.
Không chỉ một mình Nhật, Mỹ cũng đã có xu thế tương tự và điều này tác động gì? Thực ra tổng hợp một hồi thì thấy phán quyết ở Tokyo nằm trong một xu hướng rộng hơn nhiều. Tháng 8/2026, một hội đồng chuyên gia của Bộ Tư pháp Nhật đã khuyến nghị nên đối xử với giọng nói như hình ảnh. Tòa án Quận Tokyo giờ đã đi theo đúng hướng đó dù chưa có luật mới.
Ở Mỹ, câu chuyện tương tự diễn ra sớm hơn khi vào năm 1988, ca sĩ Bette Midler thắng kiện hãng Ford vì dùng một ca sĩ khác bắt chước giọng bà trong quảng cáo. Năm 2024, bang Tennessee thông qua Luật ELVIS, bổ sung giọng nói vào danh sách được bảo vệ, nhắm thẳng vào việc AI tái tạo giọng nói giống người nổi tiếng. Cũng năm 2024, OpenAI phải tạm ngừng giọng “Sky” trong ChatGPT sau khi Scarlett Johansson lên tiếng rằng nó giống giọng cô một cách đáng ngờ.
Scarlett Johansson cũng từng buộc OpenAI phải dừng giọng nói Sky vì nó giống cô một cách bất ngờ
Điểm chung của các vụ việc này là pháp luật đang dần chấp nhận một ý tưởng: giọng nói không chỉ là âm thanh, mà là một phần danh tính khi người khác có thể nghe, nhận ra, và vì vậy có thể bị lợi dụng vì mục đích cá nhân hay lợi ích kinh tế.
Thật ra, những phán quyết như thế này hoàn toàn không cấm việc AI tạo giọng. Những công cụ đọc văn bản bằng giọng tổng hợp, giọng ảo tự thiết kế hay giọng được cấp phép vẫn hoàn toàn hợp pháp. Thứ bị nhắm tới là việc cố tình sao chép giọng của một người cụ thể, dễ nhận ra, để kiếm tiền từ sức hút của họ. Dĩ nhiên, ranh giới của việc này sẽ còn gây tranh cãi với nhiều câu hỏi: giống đến mức nào thì bị coi là bắt chước? Phân tích âm học có đủ làm bằng chứng không? Nếu mô hình được huấn luyện từ giọng người khác nhưng kết quả lại giống một người nổi tiếng thì sao? Vụ Tsuda chưa trả lời hết những câu hỏi này, và mình nghĩ các vụ tiếp theo sẽ phải làm rõ dần những yếu tố này.
Với giới lồng tiếng Nhật, một ngành mà tên tuổi gắn liền với chất giọng, đây là lần đầu tiên họ có một phán quyết để dựa vào. Diễn viên lồng tiếng Megumi Ogata, người lồng tiếng Shinji Ikari trong Evangelion, cũng từng lên tiếng kêu gọi Nhật bảo vệ giọng nói trước AI. Với họ, phán quyết hôm 30/9 là một bước quan trọng: từ giờ, giọng nói của họ được tòa án Nhật công nhận là thuộc về chính họ.
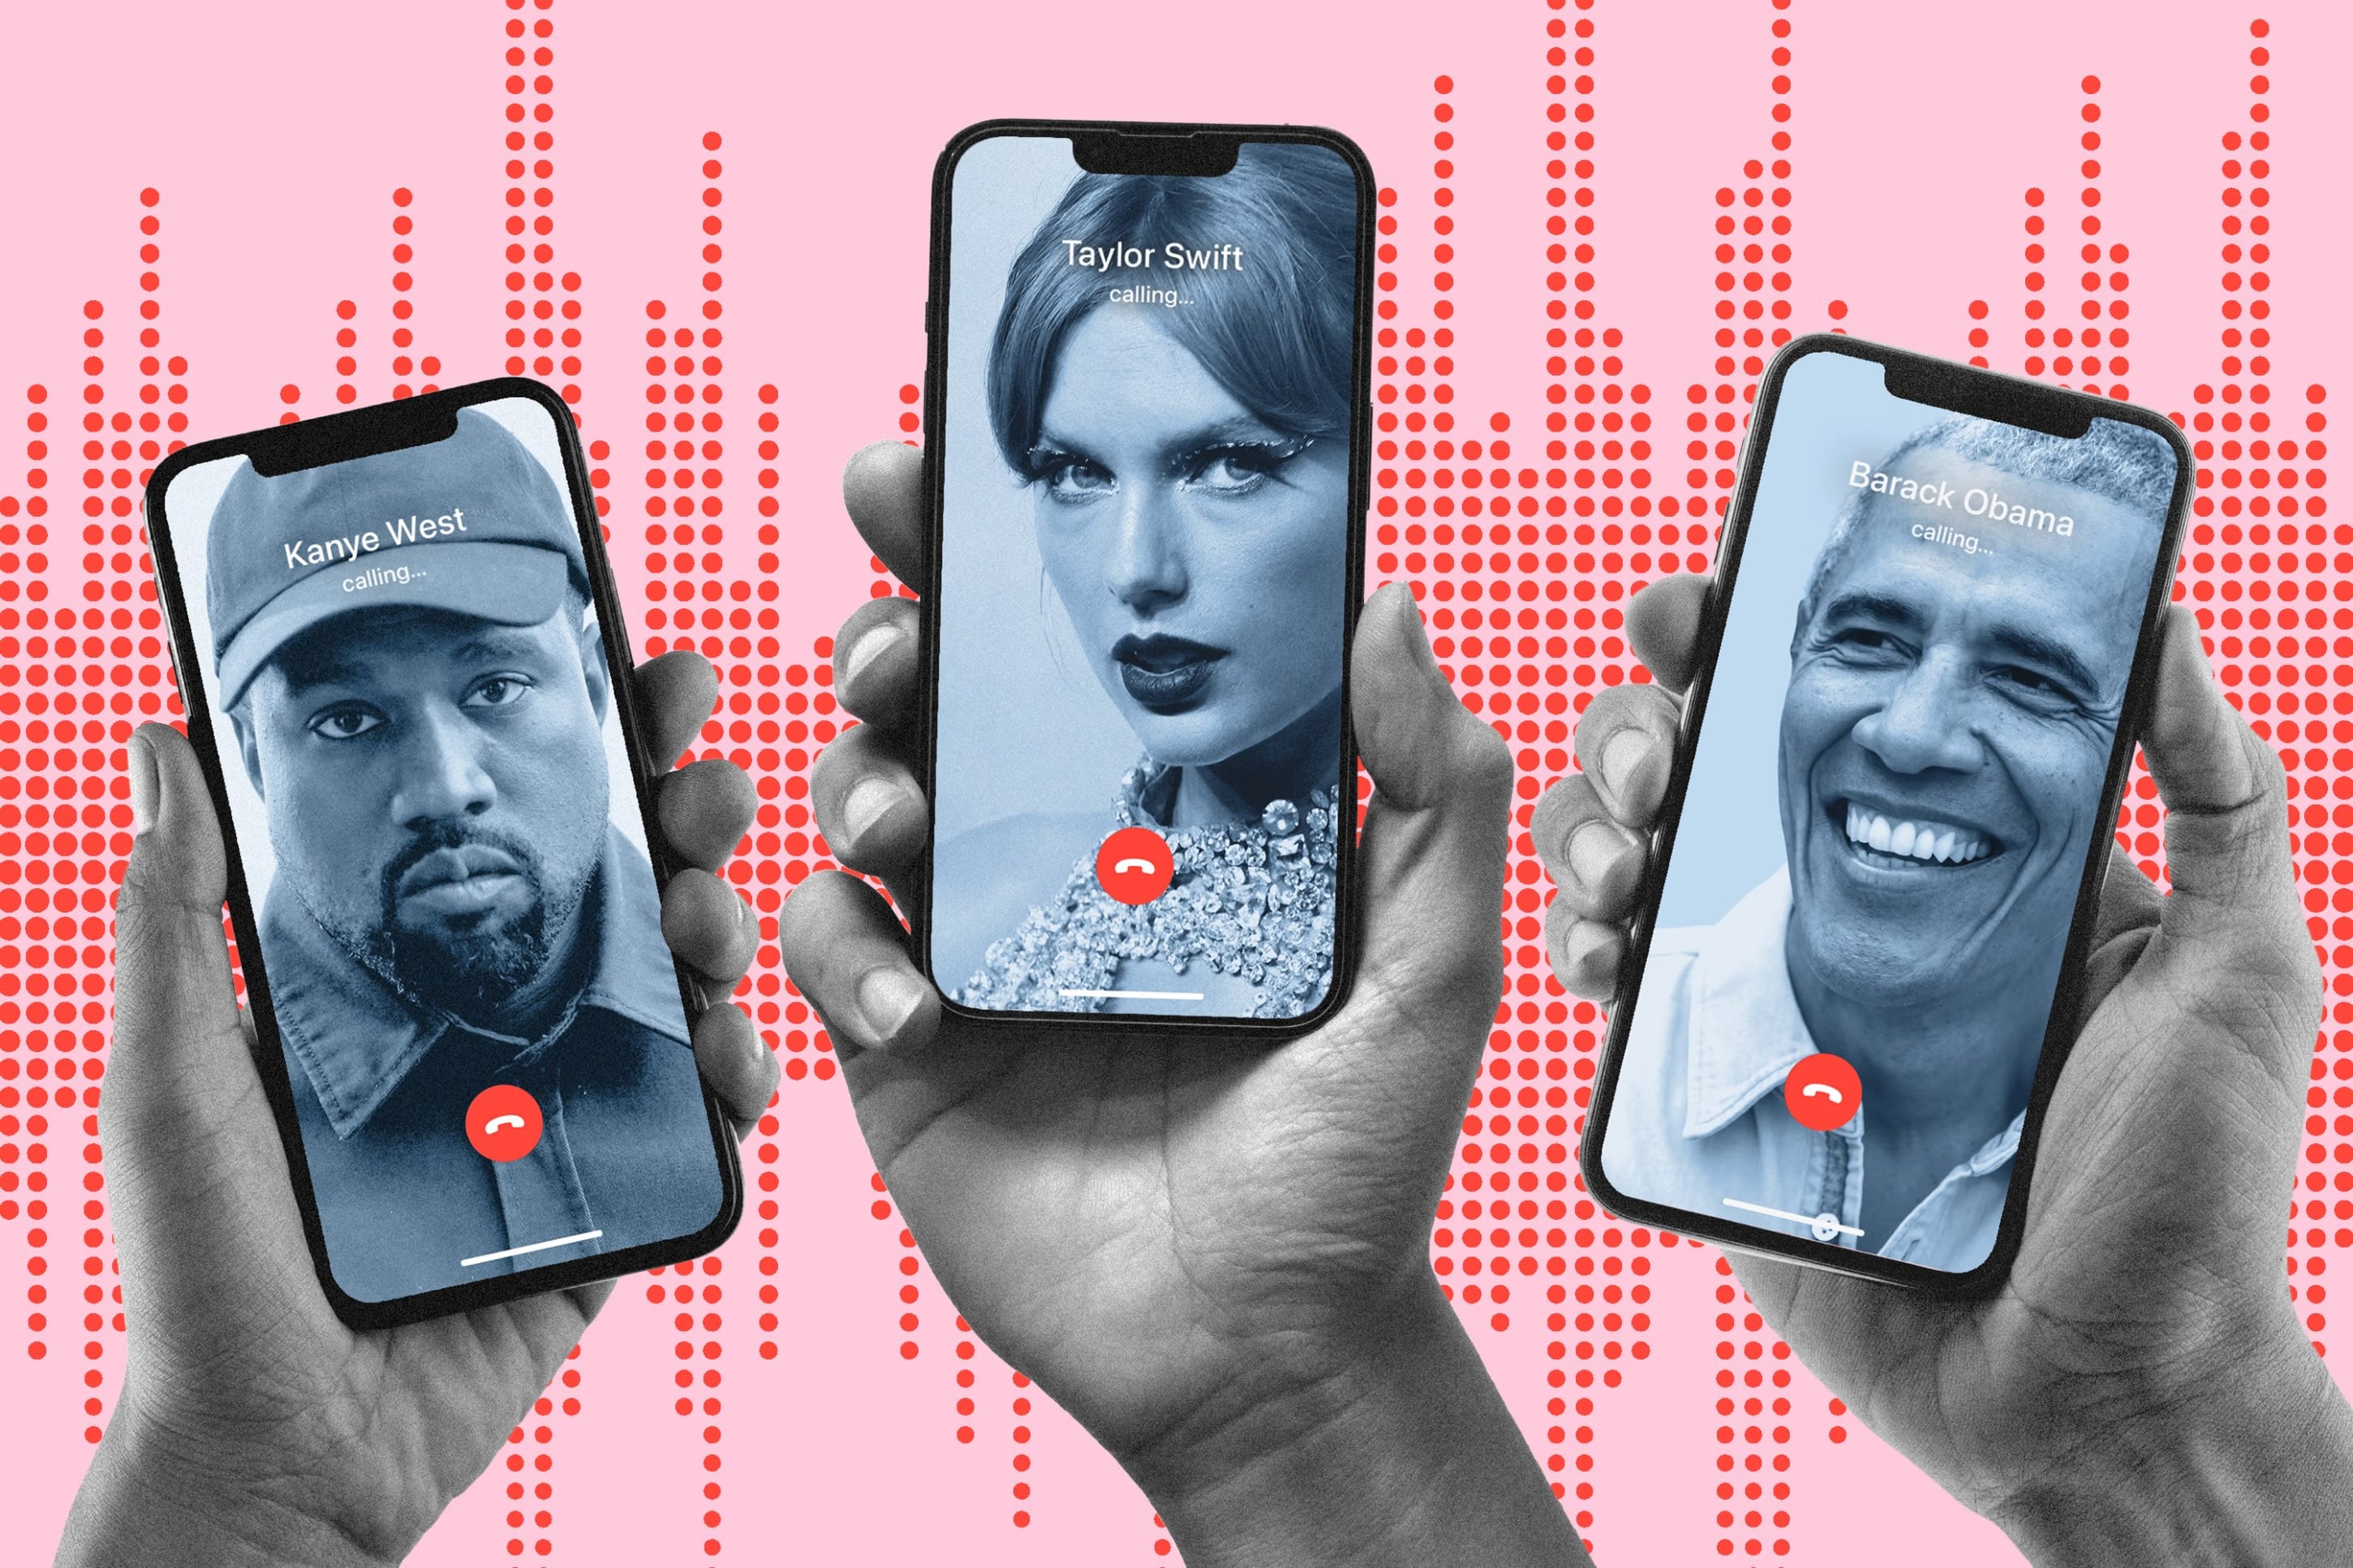
Ghi chú: ảnh đại diện mình mượn từ WSJ ý cho việc AI giả giọng người nổi tiếng