Trí tuệ nhân tạo học thế nào: chỉnh hàng triệu con số cho tới khi bớt sai | Viết bởi sonradio
Khi điện thoại nhận ra khuôn mặt trong ảnh hay dịch một câu sang tiếng Anh, không có lập trình viên nào viết sẵn quy tắc kiểu "mắt nằm trên mũi". Phần mềm tự rút ra quy tắc từ rất nhiều ví dụ. Cách học phổ biến nhất hiện nay là mạng nơ-ron nhân tạo, và bí quyết của nó nghe khá đơn giản: chỉnh hàng triệu con số nhỏ gọi là trọng số, mỗi lần một chút, cho tới khi kết quả đúng.
Khi điện thoại nhận ra khuôn mặt trong ảnh hay dịch một câu sang tiếng Anh, không có lập trình viên nào viết sẵn quy tắc kiểu "mắt nằm trên mũi". Phần mềm tự rút ra quy tắc từ rất nhiều ví dụ. Cách học phổ biến nhất hiện nay là mạng nơ-ron nhân tạo, và bí quyết của nó nghe khá đơn giản: chỉnh hàng triệu con số nhỏ gọi là trọng số, mỗi lần một chút, cho tới khi kết quả đúng.
Một nơ-ron chỉ biết nhân và cộng
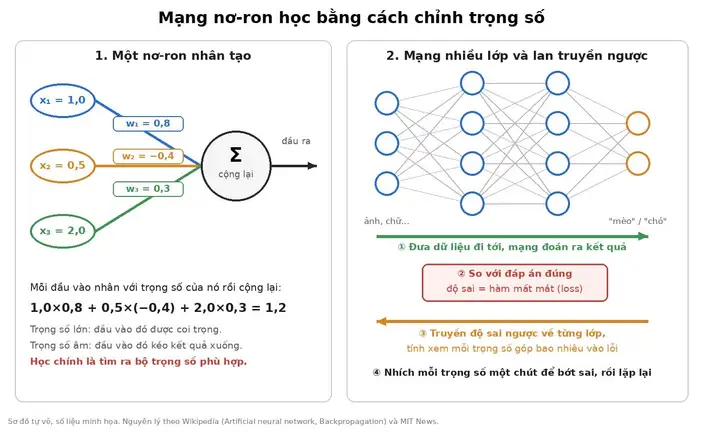
Theo MIT News, mạng nơ-ron mô phỏng một cách lỏng lẻo bộ não, gồm rất nhiều nút xử lý đơn giản nối với nhau, thường xếp thành từng lớp. Mỗi đường nối vào một nút mang một con số gọi là trọng số. Khi dữ liệu chạy qua, nút nhân từng giá trị đầu vào với trọng số tương ứng rồi cộng tất cả lại thành một số duy nhất. Nếu tổng này vượt qua một ngưỡng, nút sẽ chuyển kết quả sang lớp kế tiếp.
Trọng số lớn nghĩa là đầu vào đó được coi trọng, trọng số âm thì kéo kết quả xuống. Một mạng nhận dạng ảnh có lớp đầu vào nhận các điểm ảnh, vài lớp ở giữa và lớp đầu ra trả lời "mèo" hay "chó". Mọi thứ mạng học được đều nằm trong các trọng số đó.
Một nơ-ron nhân tạo nhân từng đầu vào với trọng số rồi cộng lại. Mạng nhiều lớp đoán ra kết quả, so với đáp án, rồi truyền độ sai ngược về để chỉnh trọng số
Theo MIT News, lúc bắt đầu huấn luyện, mọi trọng số và ngưỡng được gán giá trị ngẫu nhiên, nên mạng đoán gần như bừa. Người ta đưa vào các ví dụ đã dán nhãn sẵn, chẳng hạn hàng nghìn tấm ảnh ghi rõ là xe hơi, ngôi nhà hay cái cốc. Mỗi lần mạng đoán, kết quả được so với đáp án đúng, và khoảng cách giữa hai thứ được tính thành một con số gọi là hàm mất mát, hay loss. Đoán càng sai thì loss càng lớn. Học nghĩa là làm con số này nhỏ dần.
Hãy hình dung loss là độ cao của một vùng đồi núi, còn các trọng số là vị trí của người đứng trên đó. Muốn xuống chỗ thấp nhất trong sương mù, cách đơn giản là xem mặt đất dưới chân dốc xuống phía nào rồi bước một bước theo hướng đó, lặp lại nhiều lần. Đó là phương pháp hạ dốc theo gradient. Theo Wikipedia, nó thường được ghi công cho nhà toán học Pháp Augustin-Louis Cauchy, người đề xuất từ năm 1847.
Hạ dốc theo gradient: mỗi bước, trọng số được nhích theo hướng làm độ sai giảm, giống như dò dẫm đi xuống đáy một thung lũng
Gradient cho biết loss sẽ tăng hay giảm bao nhiêu khi nhích từng trọng số một chút. Mỗi bước, trọng số được chỉnh theo hướng ngược với gradient. Độ dài bước gọi là tốc độ học: bước nhỏ thì học chậm, bước lớn thì dễ nhảy vọt qua đáy.
Lan truyền ngược: chia phần lỗi cho từng trọng số
Một mạng có thể chứa hàng triệu trọng số, và lỗi ở đầu ra là kết quả cộng dồn của tất cả. Thuật toán lan truyền ngược, hay backpropagation, giải quyết việc chia phần lỗi. Sau khi tính loss ở lớp cuối, nó đi ngược từ đầu ra về đầu vào, từng lớp một, dùng quy tắc đạo hàm của hàm hợp để tính xem mỗi trọng số góp bao nhiêu vào lỗi. Có con số này, phương pháp hạ dốc mới biết chỉnh trọng số nào, theo hướng nào.
Theo Wikipedia, dạng hiện đại của kỹ thuật này được Seppo Linnainmaa công bố năm 1970. Bài báo trên tạp chí Nature năm 1986 của David Rumelhart, Geoffrey Hinton và Ronald Williams đã phổ biến nó, giúp huấn luyện hiệu quả các mạng nhiều lớp. Một vòng huấn luyện vì thế gồm bốn bước: đưa dữ liệu đi tới, đo độ sai, truyền độ sai ngược về, rồi nhích các trọng số, lặp lại hàng triệu lần.
Theo Cornell Chronicle, tháng 7/1958, Văn phòng Nghiên cứu Hải quân Mỹ trình diễn perceptron của nhà tâm lý học Frank Rosenblatt: một máy IBM 704 nặng 5 tấn, sau 50 lần thử, tự học được cách phân biệt thẻ đánh dấu bên trái với thẻ đánh dấu bên phải. Rosenblatt cùng cộng sự sau đó dựng cỗ máy chuyên dụng Mark I Perceptron tại Phòng thí nghiệm Hàng không Cornell ở Buffalo. Cỗ máy hiện thuộc bộ sưu tập của Bảo tàng Lịch sử Quốc gia Mỹ (Smithsonian).
Chiếc Mark I Perceptron trong ảnh do Hải quân Mỹ công bố. Máy có một "con mắt" gồm 400 tế bào quang điện, được dạy nhận dạng chữ cái in sẵn đặt trước nó
Theo Wikipedia, Mark I có 400 tế bào quang điện xếp thành lưới 20 x 20. Trọng số được lưu trong các chiết áp, và khi máy học, các mô-tơ điện xoay chiết áp để chỉnh trọng số. Việc nhích trọng số mà mạng ngày nay làm bằng phép tính, Mark I làm bằng cơ khí. Perceptron chỉ có một lớp trọng số học được nên sức học hạn chế. Phải đợi có lan truyền ngược, rồi chip đồ họa GPU tính toán song song, mạng nơ-ron mới xếp chồng được hàng chục lớp, thứ ngày nay gọi là học sâu.
Các mô hình AI ngày nay có tới hàng tỷ trọng số, nhưng cách học về cơ bản vẫn vậy: đoán, đo độ sai, tìm hướng làm bớt sai, rồi nhích từng trọng số một chút.
Nguồn: MIT News: Explained: Neural networks , Wikipedia: Gradient descent , Wikipedia: Backpropagation , Wikipedia: Perceptron , Cornell Chronicle: Professor's perceptron paved the way for AI , Smithsonian NMAH: Electronic Neural Network, Mark I Perceptron