METR: AI đang tăng tốc nghiên cứu tại Anthropic, con số gần gấp đôi nghĩa là gì?
AI đang tham gia làm ra thế hệ AI tiếp theo, chứ không chỉ viết email hay sửa code cho người dùng. Báo cáo mới của METR về Anthropic đáng chú ý ở chỗ tổ chức này được xem dữ liệu nội bộ để tìm hiểu liệu vòng lặp đó đã thực sự làm nhịp phát triển mô hình nhanh hơn hay chưa.
AI đang tham gia làm ra thế hệ AI tiếp theo, chứ không chỉ viết email hay sửa code cho người dùng. Báo cáo mới của METR về Anthropic đáng chú ý ở chỗ tổ chức này được xem dữ liệu nội bộ để tìm hiểu liệu vòng lặp đó đã thực sự làm nhịp phát triển mô hình nhanh hơn hay chưa.
Sau đợt đánh giá kéo dài 11 tuần, từ 12/8 đến 29/10/2026, METR cho rằng Anthropic có thể đang cải thiện năng lực mô hình trên các nhiệm vụ được xác định rõ với tốc độ khoảng gấp đôi giai đoạn 3/2024–10/2025. Nhưng “tiến bộ nhanh gấp đôi”, “nhân viên tự thấy năng suất tăng 12 lần” và “AI tự nghiên cứu hoàn toàn” là ba chuyện khác nhau.
Gần gấp đôi là nhịp tiến bộ, không phải trí thông minh gấp đôi
Phần dữ liệu công khai rõ nhất là AECI, phiên bản chỉ số năng lực tổng hợp mà Anthropic xây dựng dựa trên Epoch Capabilities Index. METR dùng điểm benchmark của các mô hình, bao gồm cả những bản chỉ dùng nội bộ, để ước lượng xu hướng tiến bộ theo thời gian.
Theo cách tính chính, từ tháng 10/2025, tốc độ tăng AECI của Anthropic cao hơn khoảng 1,9 lần so với trước đó; khoảng tin cậy 95% là 1,5–2,8 lần. Đồ thị thể hiện nhịp tăng từ khoảng 15 lên 29 điểm mỗi năm. Có thể hiểu nôm na là một năm gần đây đem lại lượng tiến bộ trên chỉ số này tương đương gần hai năm theo nhịp cũ.
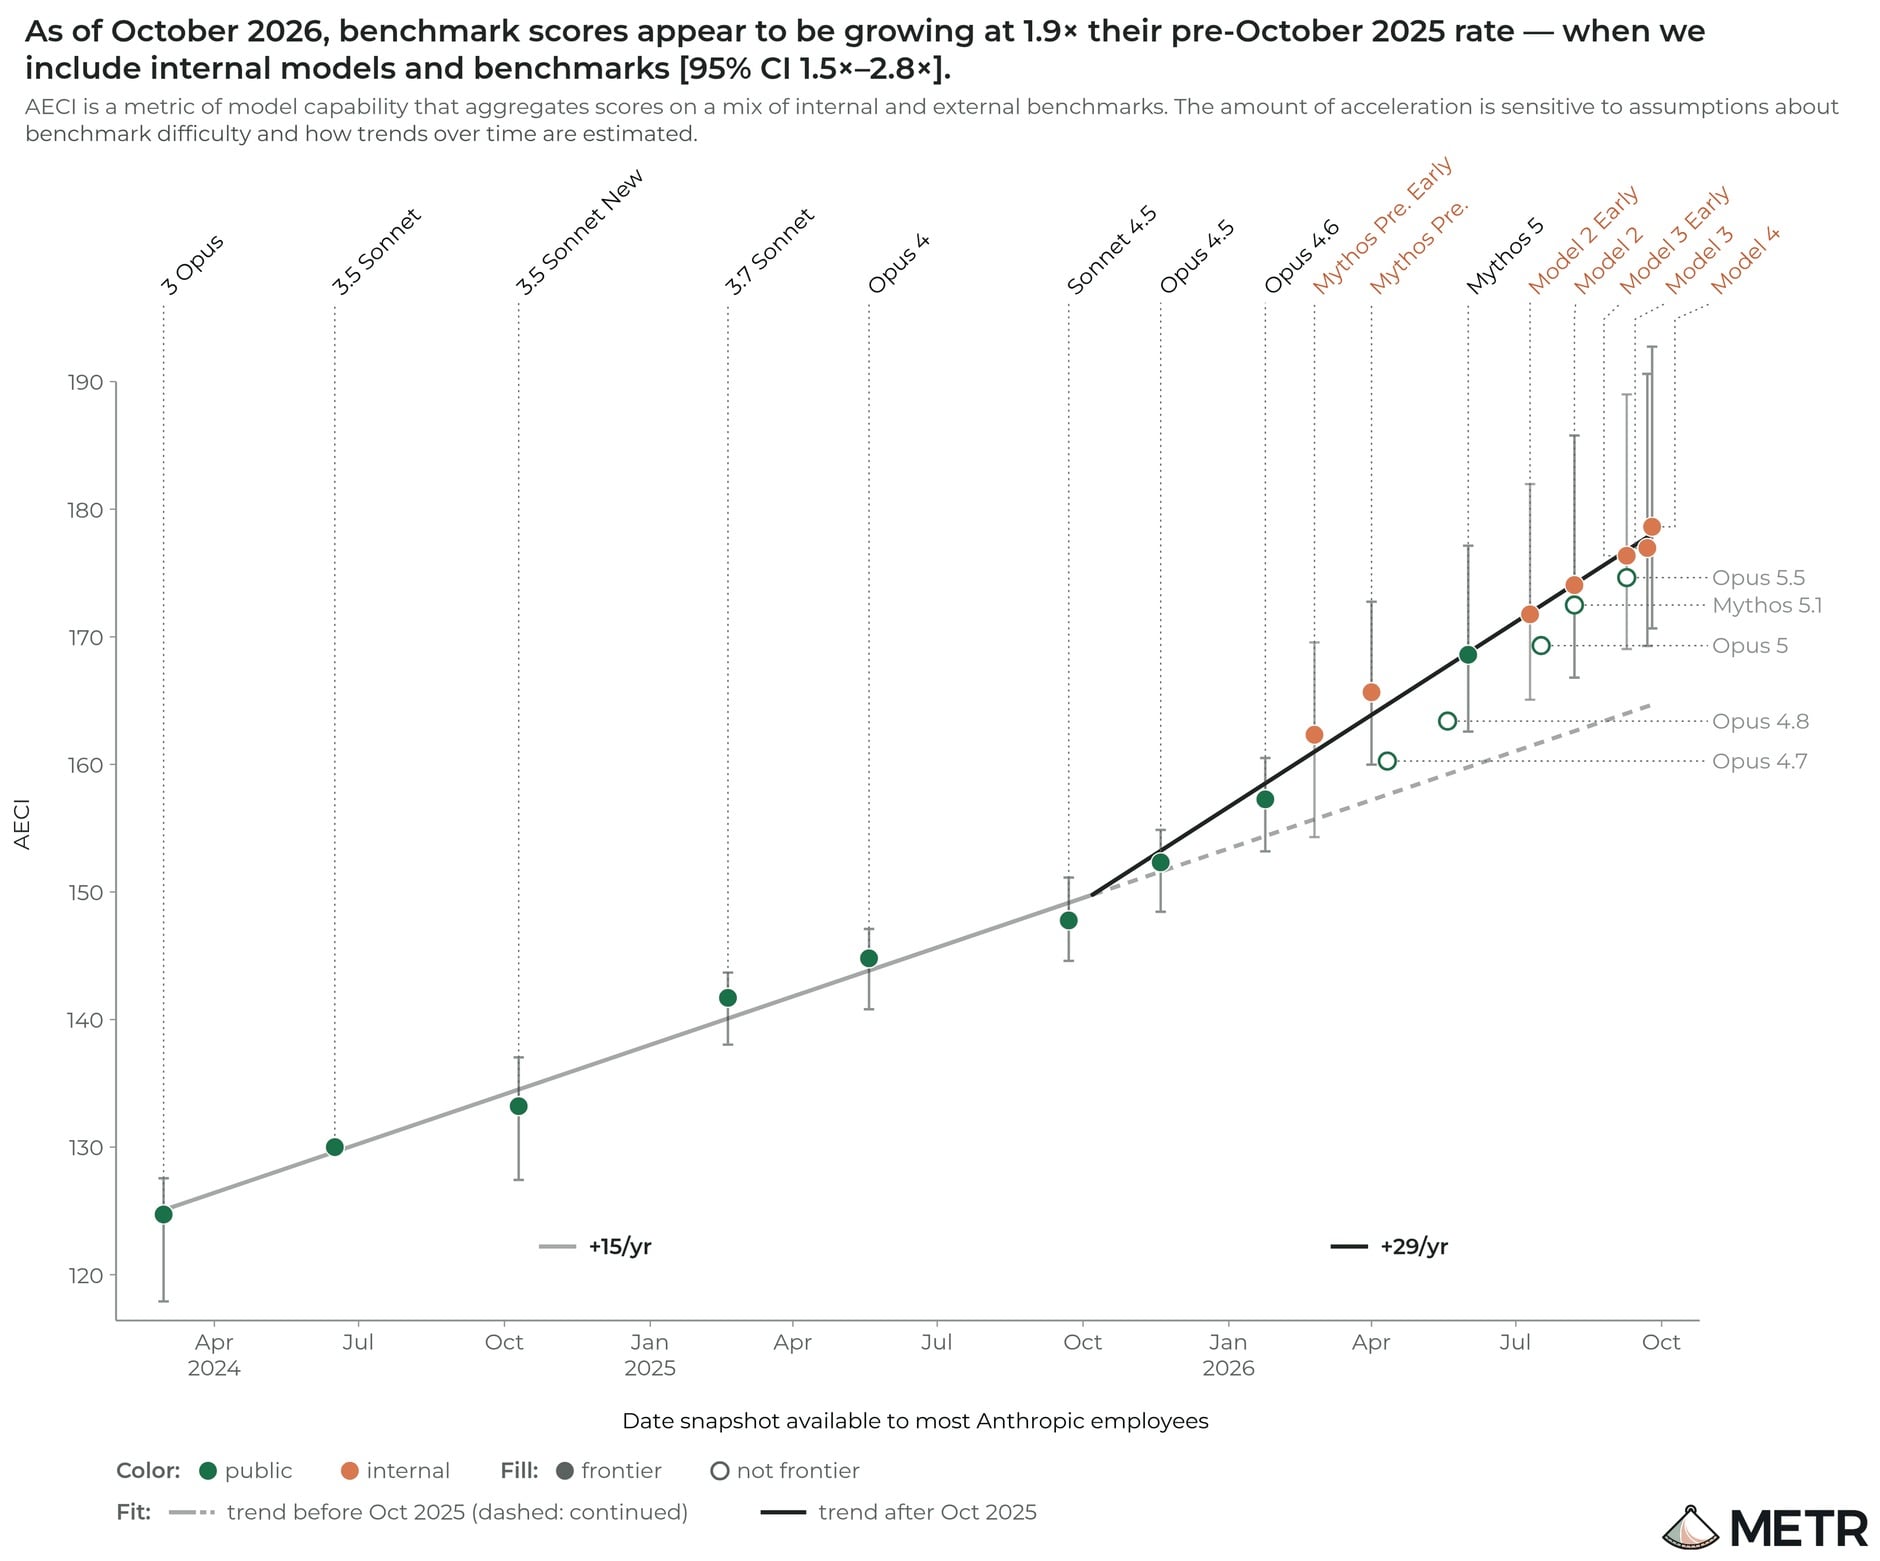
Xu hướng AECI của Anthropic tăng nhanh hơn từ cuối năm 2025; các mô hình chỉ dùng nội bộ được đánh dấu màu cam. Đồ họa: METR.
Đây không phải phát biểu rằng một câu trả lời của Claude thông minh gấp đôi, hay mọi công việc đều hoàn thành nhanh gấp đôi. Nó mô tả độ dốc của một thước đo năng lực qua nhiều mô hình. Mối liên hệ giữa điểm số đó và giá trị sử dụng ngoài đời vẫn có thể thay đổi.
Kết luận rộng hơn của METR là ước lượng mang tính phán đoán, có kết hợp cả bằng chứng không được công bố: nhịp cải thiện trên nhiệm vụ rõ ràng có lẽ quanh mức gấp đôi, nhưng 1,3 hay 3 lần cũng không khiến nhóm ngạc nhiên. Khoảng này khác với khoảng tin cậy thống kê của phép khớp AECI phía trên.
Con số 12 lần đến từ nhân viên tự đánh giá
Con số dễ gây chú ý hơn là mức tăng năng suất khoảng 12 lần khi dùng mô hình nội bộ mạnh nhất vào tháng 10/2026. Trong báo cáo, đây là mức tăng trung bình do người trả lời tự ước lượng, không phải kết quả của thử nghiệm giao cùng công việc cho hai nhóm có và không có AI.
Dữ liệu gần nhất đến từ các cuộc bình chọn trên Slack: nhân viên dùng biểu tượng phản ứng để chọn mức tăng tốc mà họ cảm nhận được. METR gọi đây là bằng chứng rất lỏng, vì mẫu trả lời có thể không đại diện, câu trả lời ít được cân nhắc kỹ và tự đánh giá có thể cao hơn tác động năng suất thực.
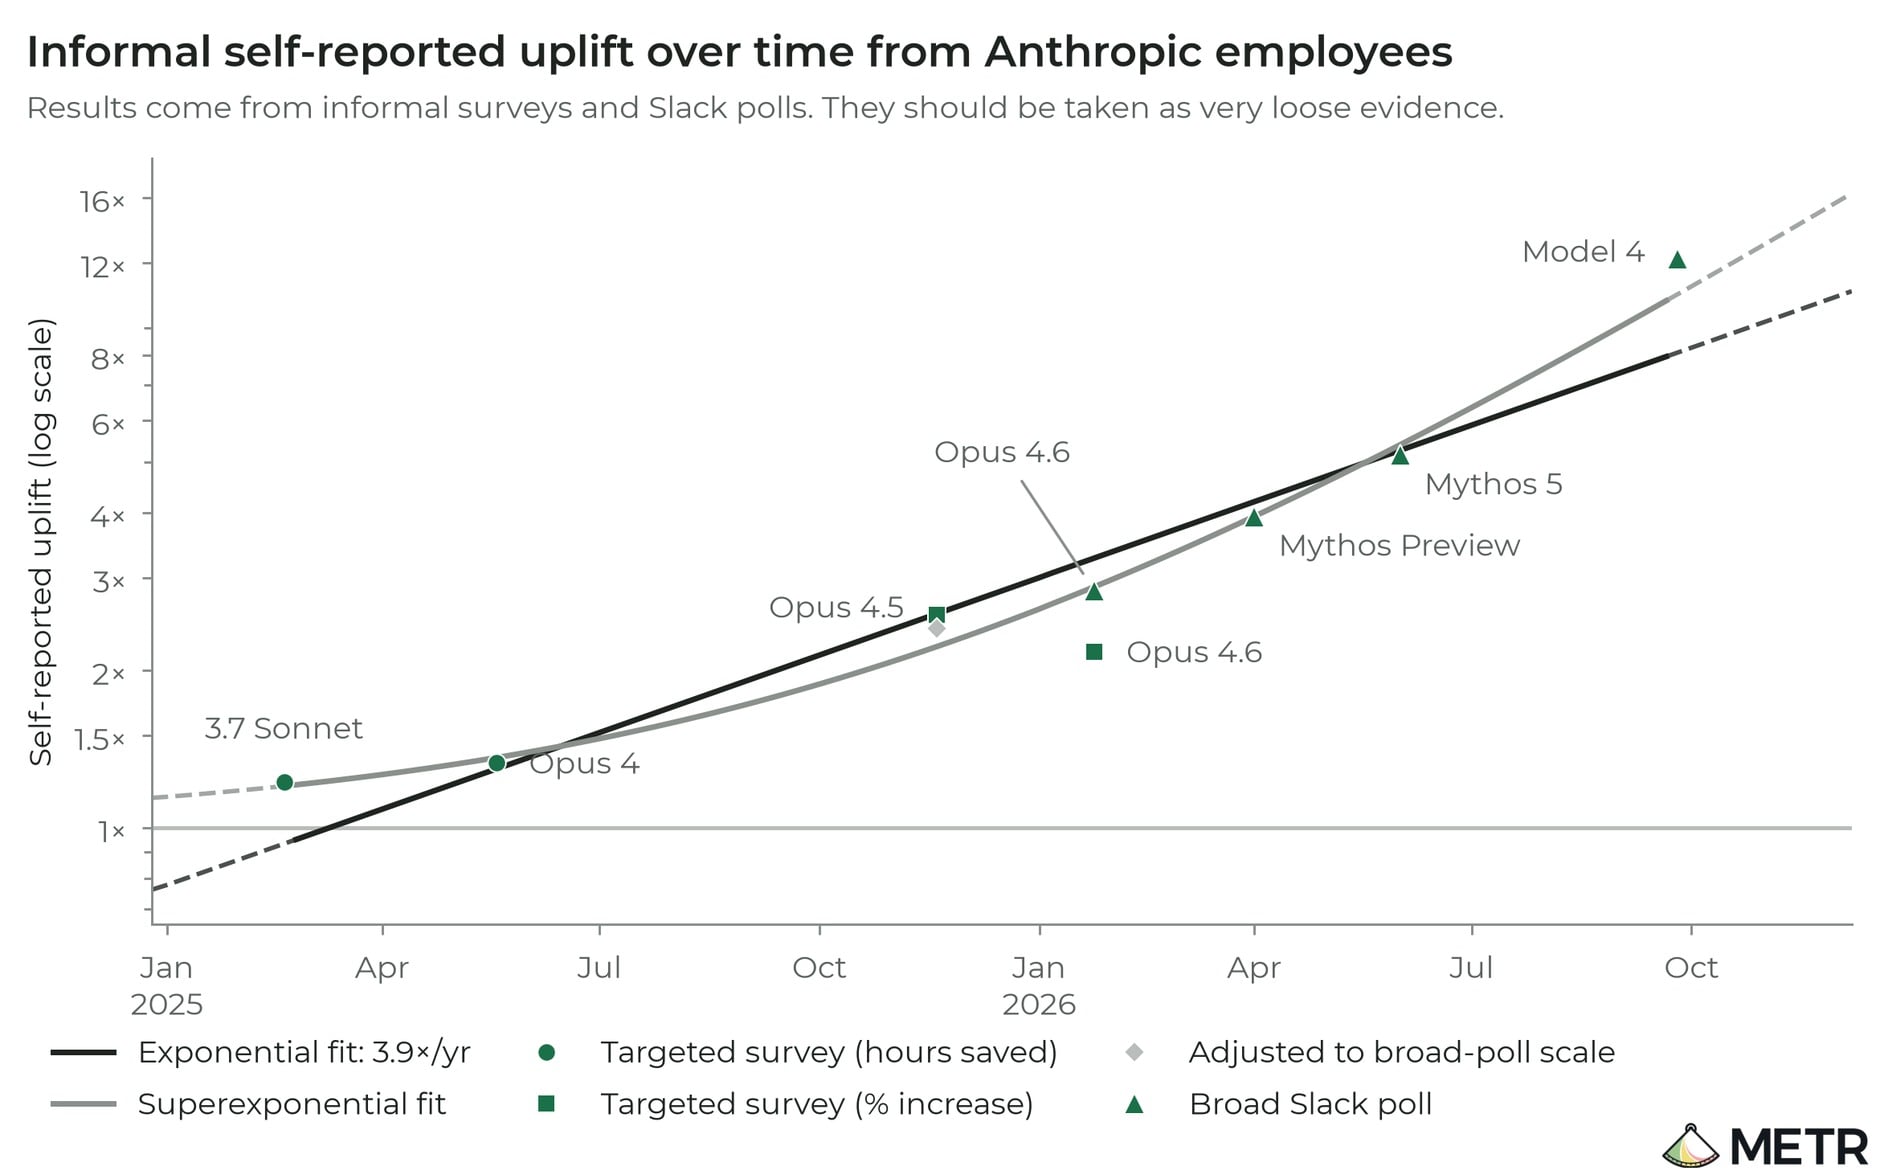
Mức tăng năng suất do nhân viên tự báo cáo tăng theo thời gian, đạt khoảng 12 lần với Model 4; đây không phải phép đo năng suất có đối chứng. Đồ họa: METR.
Dù vậy, xu hướng tự báo cáo tăng lên vẫn là một tín hiệu để điều tra tiếp. Các cuộc phỏng vấn sâu cũng cho thấy nhiều nhà nghiên cứu thấy AI hỗ trợ đáng kể. Nhưng ý kiến không đồng nhất: có người nghiêng về AI là động lực chính, có người đánh giá tuyển dụng hoặc những yếu tố khác quan trọng hơn.
Điều mình thấy cần tách bạch là năng suất của một cá nhân và tốc độ tiến bộ của cả phòng nghiên cứu. Viết code nhanh hơn, thử được nhiều ý tưởng hơn chưa có nghĩa mọi ý tưởng đều tốt hay mọi công đoạn cùng tăng tốc. Vì thế không thể lấy 12 lần để thay cho con số gần gấp đôi ở phần đầu.
Không đơn giản là mua thêm máy tính để huấn luyện
METR đã xem xét những nguyên nhân khác nhau: tăng sức tính toán (compute), tuyển người, cải thiện dữ liệu, phát hiện thuật toán và tháo gỡ các nút thắt. Nhóm nói họ có bằng chứng thuyết phục rằng sự tăng tốc không đến từ việc tốc độ mở rộng quy mô tính toán huấn luyện đã tăng lên; chi tiết của bằng chứng này bị lược bỏ khỏi bản công khai.
Điểm này không có nghĩa GPU hay compute hết quan trọng. Câu hỏi ở đây là vì sao nhịp tiến bộ đổi nhanh hơn trước, chứ không phải huấn luyện mô hình còn cần phần cứng hay không. Thuật toán, chất lượng dữ liệu và compute vẫn cùng góp phần tạo ra năng lực mô hình.
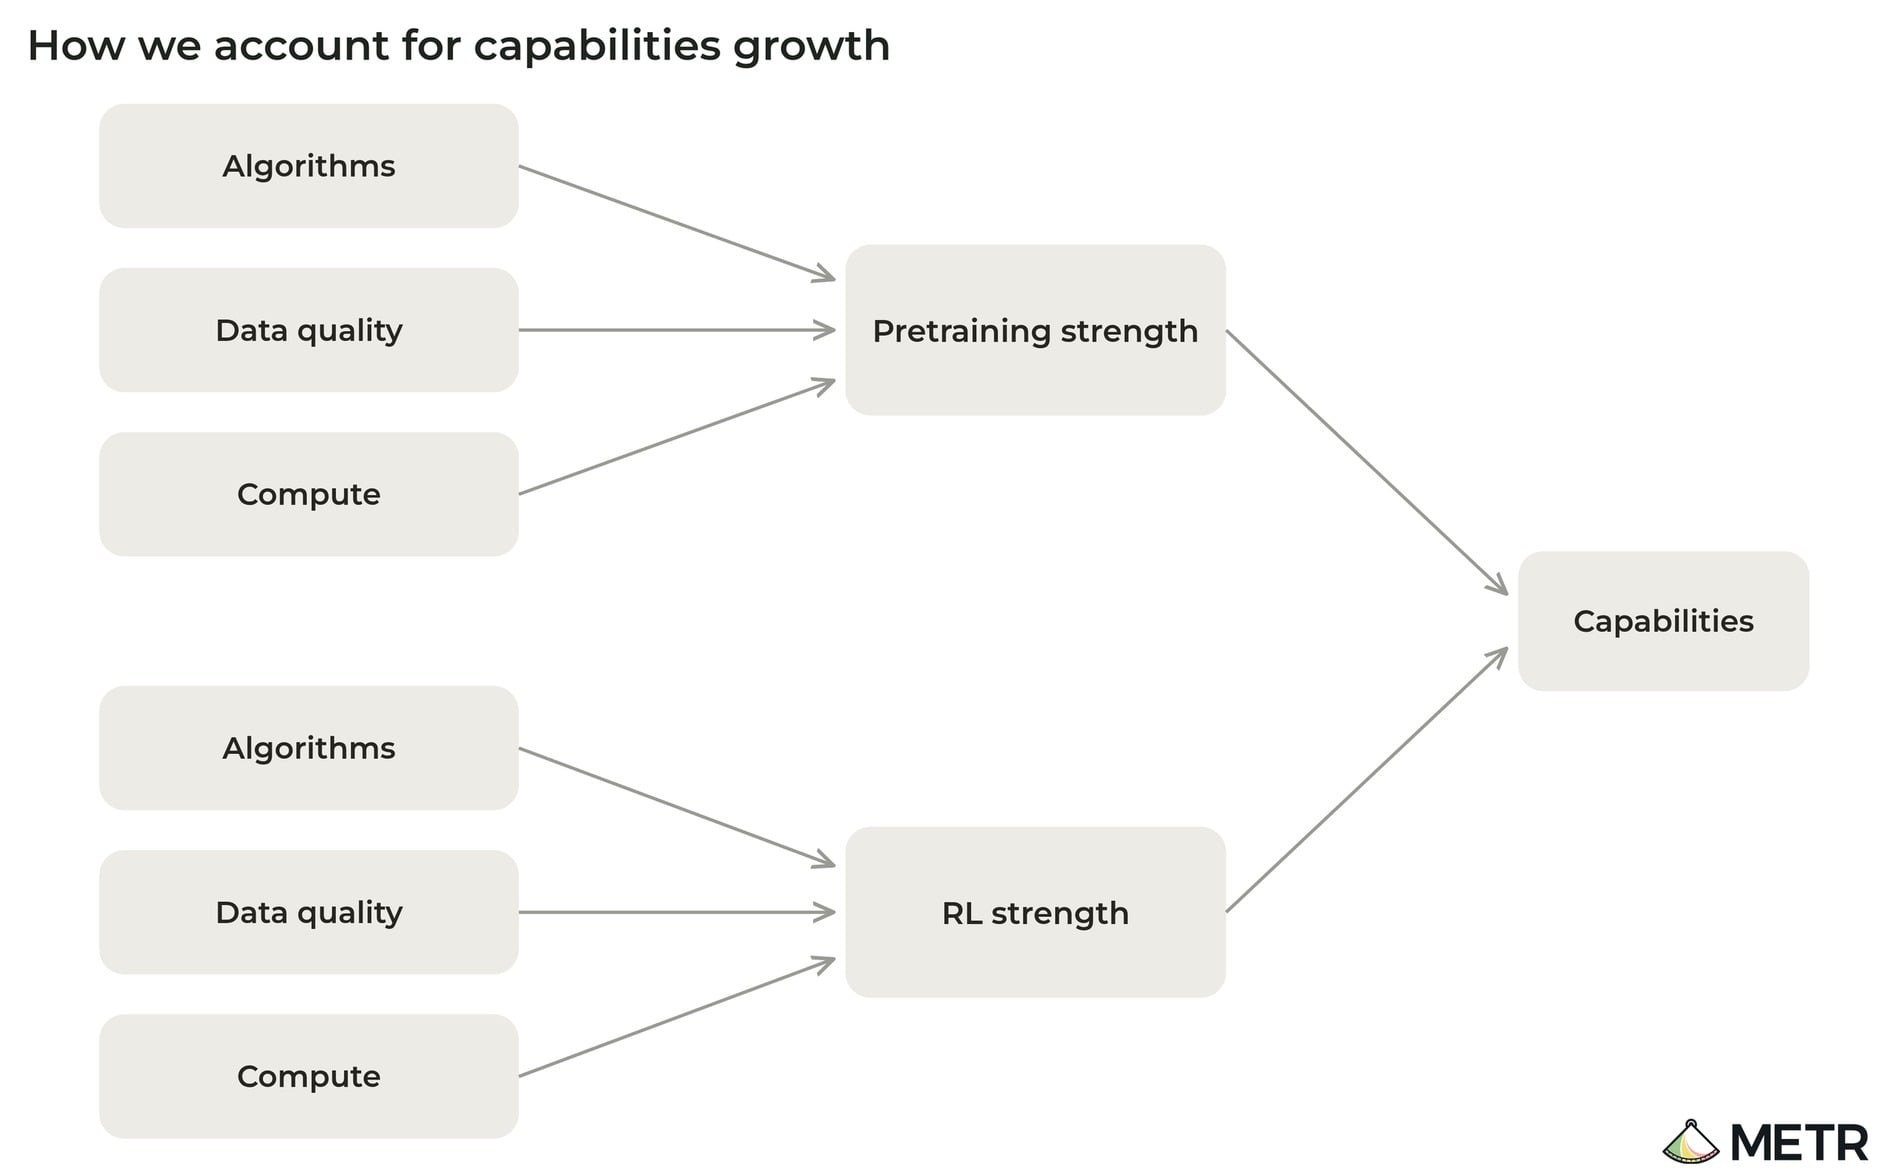
Khung phân tích liên hệ thuật toán, dữ liệu và compute với tiền huấn luyện, học tăng cường và năng lực mô hình. Đây là sơ đồ quan hệ, không phải tỷ trọng đóng góp đã đo được. Đồ họa: METR.
Nhận định tổng hợp của METR là phần lớn sự tăng tốc tại thời điểm tháng 10/2026 có lẽ đến từ việc dùng AI làm nghiên cứu và phát triển. Nhóm nhấn mạnh điều này còn rất không chắc chắn, và các yếu tố không phải AI có thể đã góp phần lớn vào giai đoạn tăng tốc cuối năm 2025.
Cơ chế dễ hình dung nhất vẫn là AI hỗ trợ người nghiên cứu: giảm công triển khai, giúp thử nhiều ý tưởng và rút ngắn đường từ ý tưởng đến thí nghiệm. Theo báo cáo, đóng góp hoàn toàn tự chủ chưa phải nguồn tiến bộ lớn ở những phần quan trọng nhất của quy trình huấn luyện, dù một số lĩnh vực đã xuất hiện dấu hiệu ban đầu.
Có những mô hình người dùng chưa được tiếp cận
Một lý do báo cáo đáng đọc là nó không chỉ nhìn vào sản phẩm đã phát hành. METR dùng ký hiệu Model 2 cho mô hình hoàn tất huấn luyện tháng 7/2026, Model 3 vào tháng 8–9 và Model 4 vào tháng 9–10. Đây là những mô hình chưa phát hành khi đánh giá, và các ký hiệu được chia sẻ với METR không nhất thiết là tên gọi nội bộ thật.
Mốc thời gian trên đồ thị cũng là lúc phần lớn nhân viên Anthropic có thể sử dụng mô hình, không mặc định là ngày công bố cho khách hàng. Chi tiết này quan trọng: nếu chỉ nhìn lịch ra mắt công khai, anh em có thể đang thấy một bức tranh chậm hơn diễn biến bên trong phòng nghiên cứu.
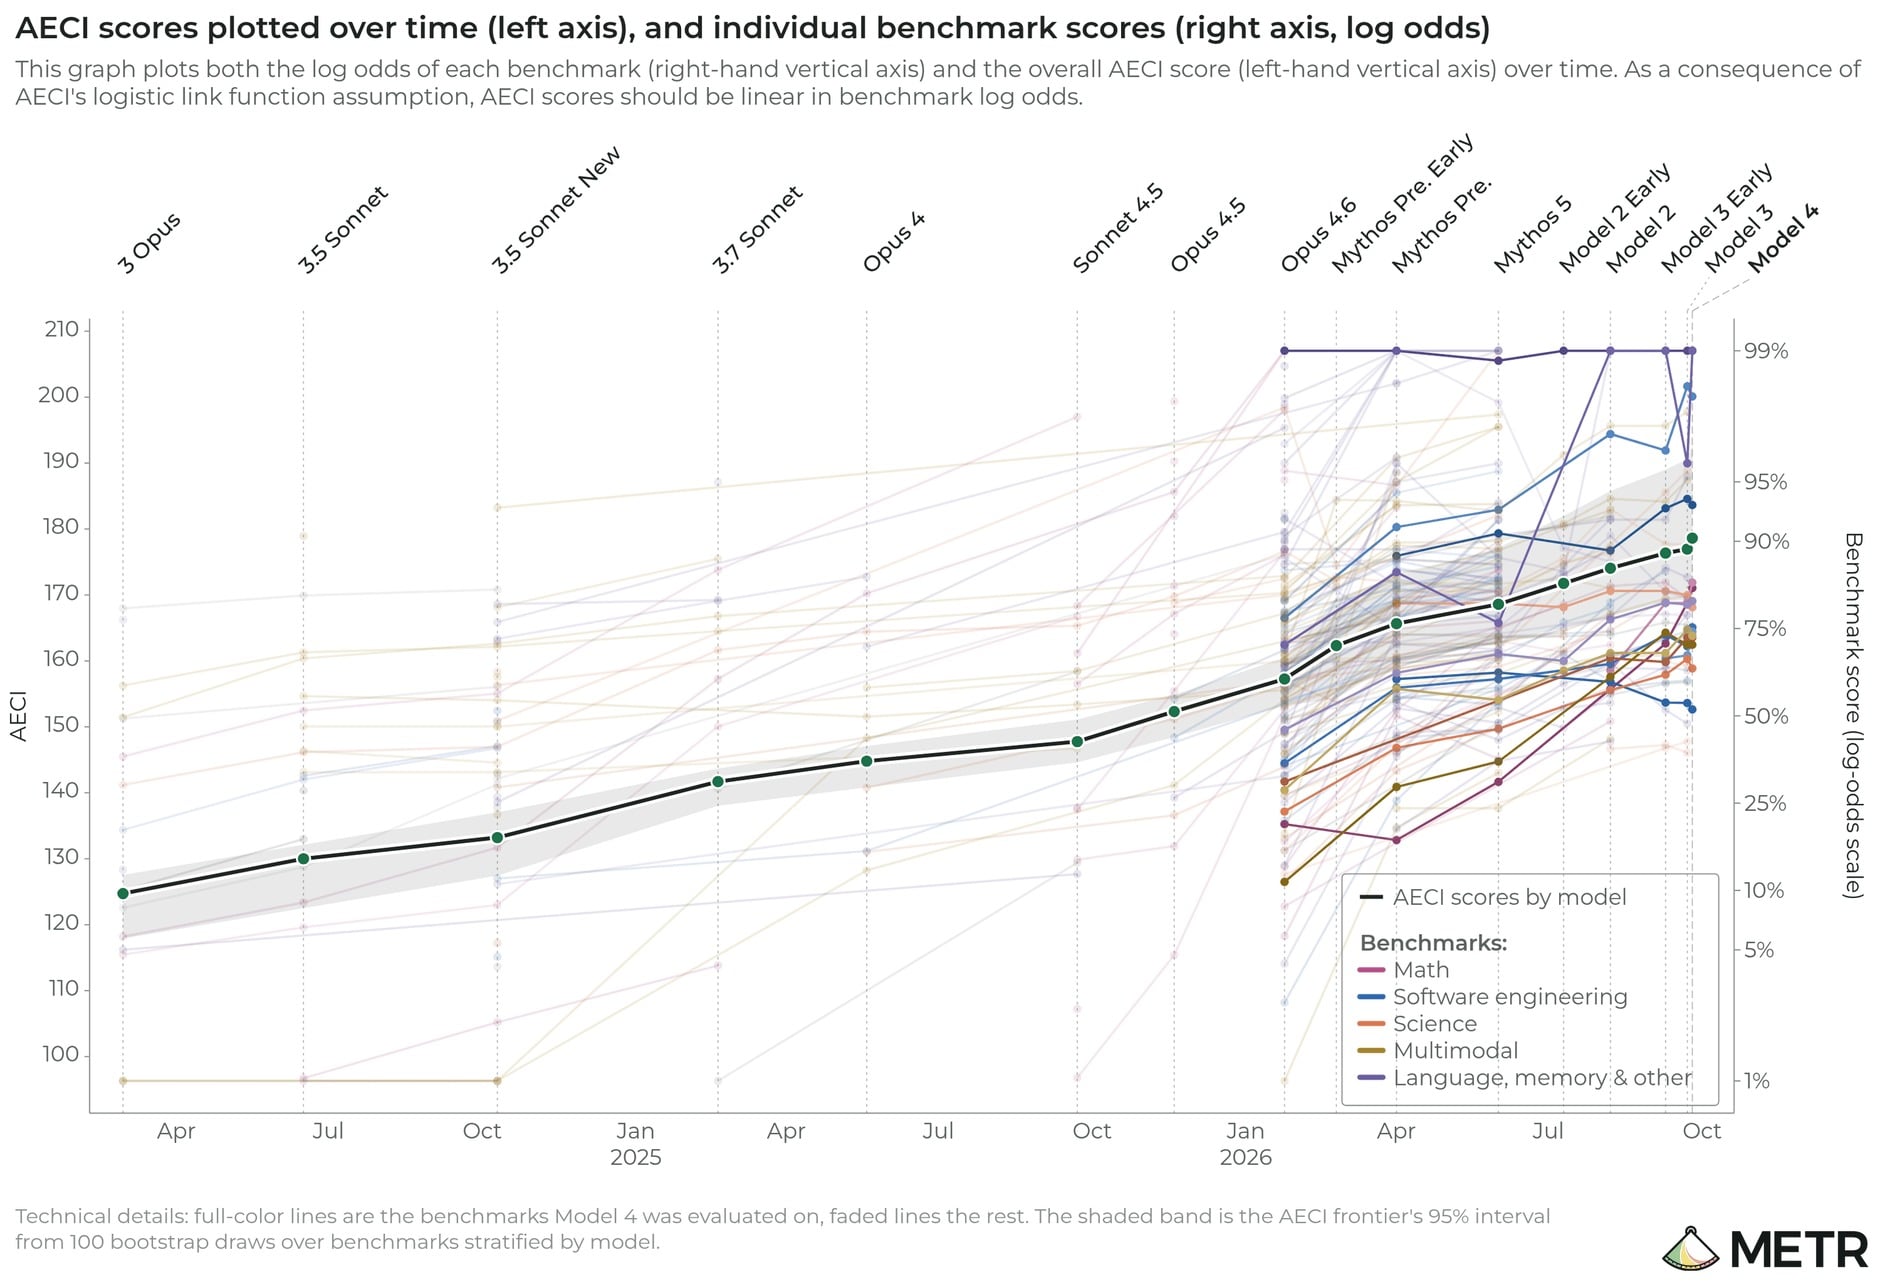
Các nhóm benchmark trong AECI; Model 4 đạt trên 50% ở cả 15 benchmark được dùng để đánh giá mô hình này. Đồ họa: METR.
METR còn lưu ý Model 4 đã vượt 50% ở cả 15 benchmark được dùng cho nó trong AECI. Điều đáng nói không phải mô hình đã “giỏi mọi thứ”, mà là số bộ kiểm tra đủ khó để phân biệt năng lực có thể đang ít dần. Một thước đo bắt đầu bão hòa sẽ khiến việc theo dõi tiến bộ sau này khó hơn.
Bởi vậy, không thể chuyển thẳng các kết quả nội bộ này thành lời hứa về một bản Claude sắp ra mắt, hay kết luận người dùng hiện tại đã có đầy đủ năng lực được mô tả. Báo cáo có cả dự báo cho một mô hình tương lai, nhưng phần đó không xuất hiện trong bản công khai.
Bằng chứng bị che và câu hỏi về an toàn
Giới hạn lớn nhất nằm ở quyền tiếp cận và quyền công bố. METR nói Anthropic chia sẻ nhiều dữ liệu hơn dự kiến, nhưng đợt này không có quyền truy cập tự do như nhân viên, cũng không trực tiếp dùng các mô hình chưa công bố. Nó khác chương trình đánh giá có quyền tiếp cận tương đương nhân viên được Anthropic thông báo ngày 15/10.
Anthropic có quyền yêu cầu lược bỏ thông tin chưa công khai. Theo METR, phần lớn bằng chứng mà nhóm thấy hữu ích nhất cho kết luận đã bị lược bỏ, khiến người ngoài phải dựa vào phán đoán của METR nhiều hơn mức lý tưởng. Phần xác minh phân bổ compute giữa nghiên cứu năng lực và an toàn cũng bị bỏ khỏi phạm vi giữa chừng, trước khi nhóm có kết luận thực chất.
Ngay cả phần benchmark có thể đọc được cũng không cho một con số bất biến. Thay đổi giả định toán học trong phân tích độ nhạy có thể cho ước lượng tăng tốc từ 1,1 đến 2,9 lần. Khi mở rộng đồ thị sang mô hình của nhiều nhà phát triển, phép khớp cho khoảng 1,4 lần thay vì 1,9 lần của riêng Anthropic. Đó là những cách phân tích khác nhau, không phải các phép đo có thể trộn lẫn.
METR cũng so sánh khả năng năng lực chỉ nhảy bậc một lần với khả năng tốc độ tăng đã đổi sang một nhịp mới. Dữ liệu các mô hình mới khiến kịch bản thứ hai có vẻ hợp lý hơn.
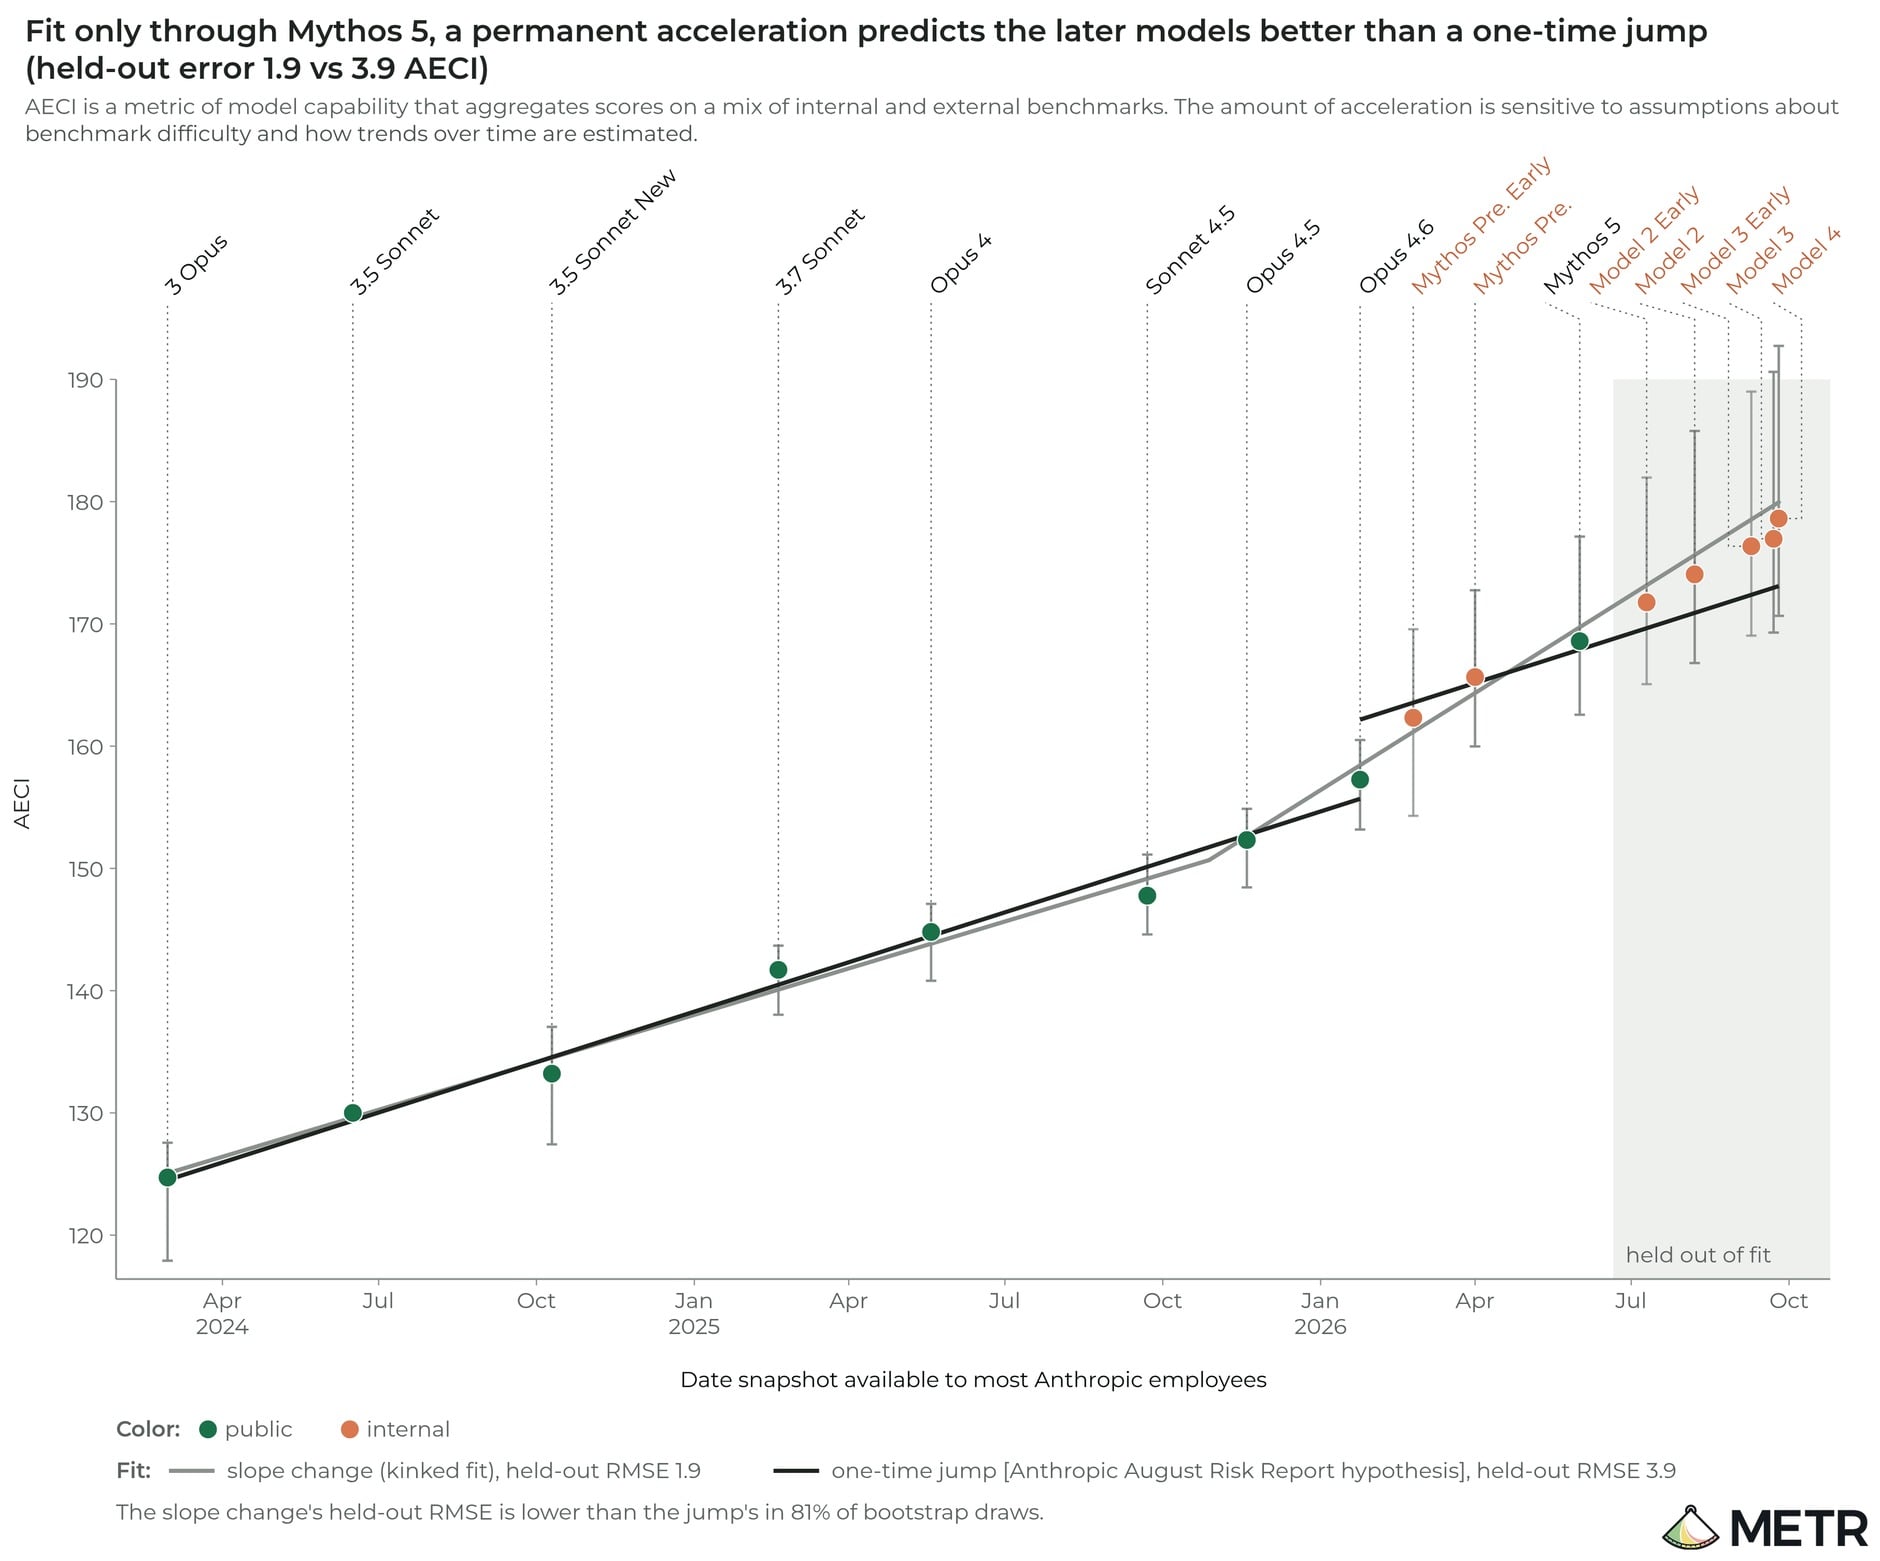
METR so sánh một bước nhảy năng lực đơn lẻ với việc chuyển sang nhịp tiến bộ nhanh hơn; dữ liệu mô hình mới nghiêng về khả năng thứ hai. Đồ họa: METR.
Phản hồi trên X, đồng sáng lập Anthropic Sam McCandlish đồng ý AI đang giúp nghiên cứu nhanh hơn nhưng khó nói chính xác bao nhiêu. Ông thừa nhận việc lược bỏ nhiều thông tin khiến người ngoài khó kiểm tra, đồng thời bảo vệ quyết định này vì bí mật thương mại và nguy cơ cung cấp cho các phòng nghiên cứu khác một lộ trình tăng tốc tương tự.
Đó là một đánh đổi có thật trong cách giám sát công nghệ: chia sẻ đủ chi tiết để kiểm chứng, nhưng không vô tình phổ biến chính những cách tăng tốc đang cần đánh giá rủi ro. Mình không nghĩ nên bỏ qua bên nào. Có báo cáo độc lập là hữu ích, nhưng tính độc lập của kết luận không tự động khiến toàn bộ bằng chứng trở nên kiểm chứng được.
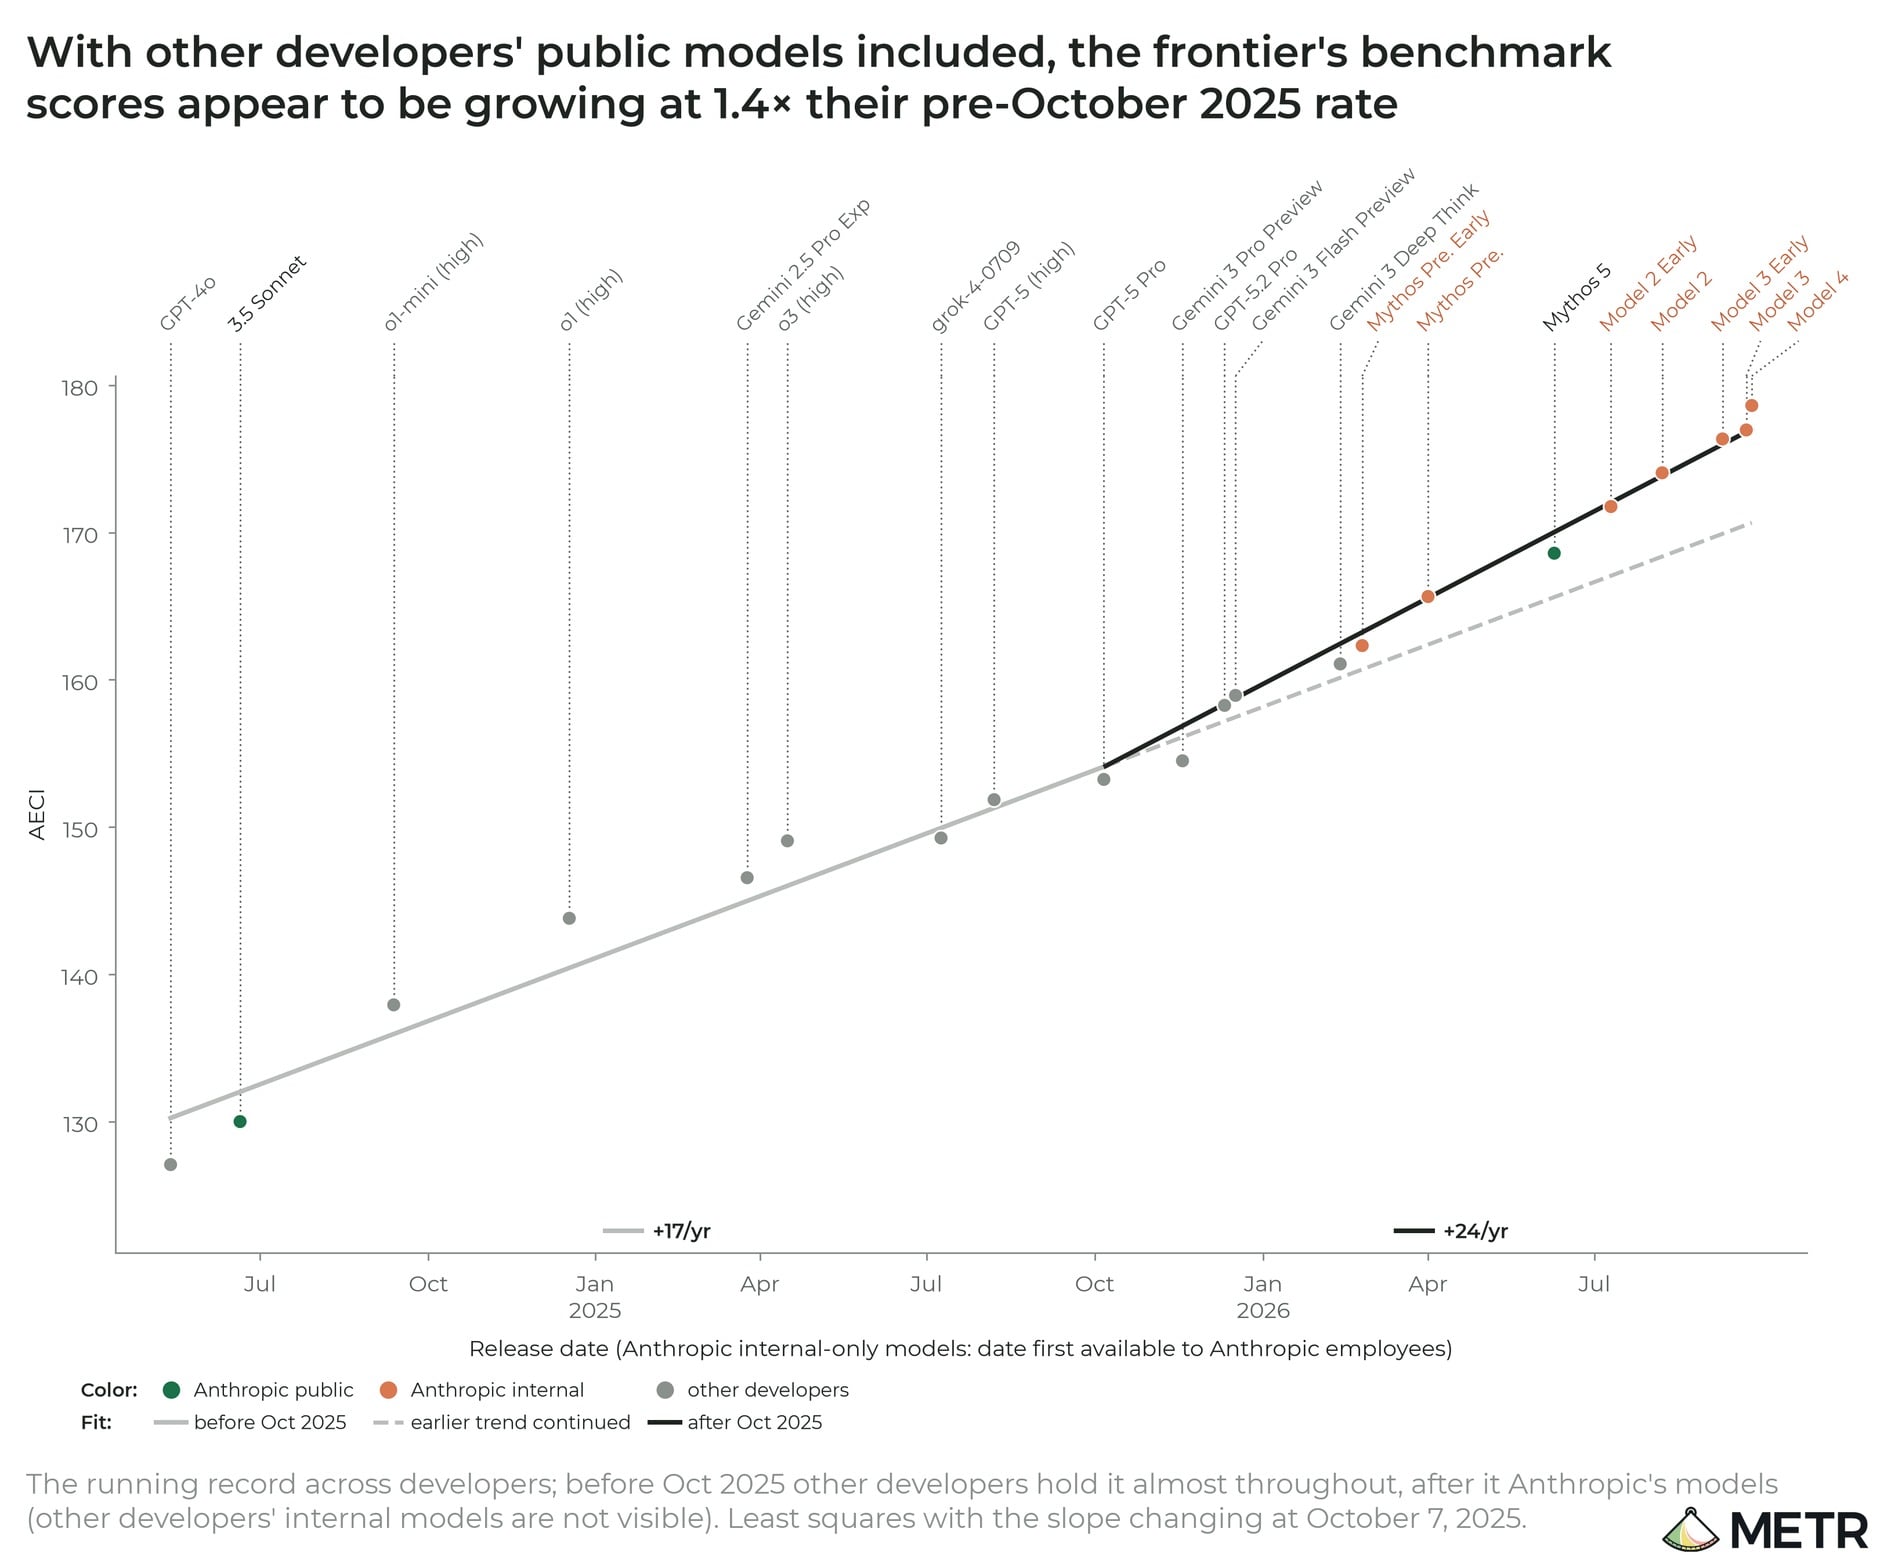
Đồ thị mở rộng sang mô hình của nhiều nhà phát triển cho mức tăng tốc ước lượng khoảng 1,4 lần; phạm vi khác với phân tích riêng Anthropic. Đồ họa: METR.
Về an toàn, vấn đề cần theo dõi là vòng lặp: mô hình tốt hơn giúp làm nghiên cứu hiệu quả hơn, rồi nghiên cứu đó tạo ra mô hình tốt hơn nữa. Nếu nhịp này tiếp tục nhanh lên, thời gian dành cho đánh giá và bổ sung biện pháp kiểm soát có thể bị thu hẹp. Nhưng báo cáo chưa chứng minh một hệ thống đã tự vận hành trọn vòng lặp mà không cần con người.
METR chưa thấy bằng chứng rõ ràng về nút thắt sẽ chặn tiến bộ trong 12 tháng tới, song cũng nói đánh giá của họ đã thay đổi nhiều lần khi nhận thêm dữ liệu và vẫn có thể bỏ sót yếu tố quan trọng. Với mình, điều đáng giữ lại không phải lời khẳng định AI đã tự làm mọi thứ, mà là nhu cầu đo nhịp tiến bộ lẫn khả năng giám sát tốt hơn, trước khi nhịp nghiên cứu tăng nhanh hơn khả năng hiểu nó.
Mình cũng có chém gió công nghệ ở Facebook này: https://www.facebook.com/trananhtu57/