GPT-6 Cyber săn lỗ hổng mà không vượt rào: từ sâu Morris 1988 đến agent biết dừng
Ngày 5/11/2026 (giờ Mỹ), tức sáng nay 6/11 giờ Việt Nam, OpenAI giới thiệu GPT-6 Cyber : một mô hình chuyên tìm và kiểm chứng lỗ hổng bảo mật, nhưng chỉ trong phạm vi nhà nghiên cứu đã đặt ra. Không phải bản ChatGPT thường được "bơm thêm" vài mẹo hack, mà là một dòng riêng trong hệ sinh thái Daybreak. Trên khung Preparedness Framework về an ninh mạng của OpenAI, GPT-6 Cyber được xếp Critical — cao hơn mức High của GPT-5.6 Cyber trước đó.
Ngày 5/11/2026 (giờ Mỹ), tức sáng nay 6/11 giờ Việt Nam, OpenAI giới thiệu GPT-6 Cyber : một mô hình chuyên tìm và kiểm chứng lỗ hổng bảo mật, nhưng chỉ trong phạm vi nhà nghiên cứu đã đặt ra. Không phải bản ChatGPT thường được "bơm thêm" vài mẹo hack, mà là một dòng riêng trong hệ sinh thái Daybreak. Trên khung Preparedness Framework về an ninh mạng của OpenAI, GPT-6 Cyber được xếp Critical — cao hơn mức High của GPT-5.6 Cyber trước đó.
Có một chi tiết dễ bỏ qua trong cách OpenAI kể chuyện: họ không chỉ nói "tìm được bug", mà nhấn mạnh "finds/validates exploits while staying in researcher-set scope" — tìm và kiểm chứng exploit trong khi vẫn nằm trong phạm vi do nhà nghiên cứu đặt. Hai động từ ấy quan trọng ngang nhau. Tìm mà không kiểm chứng thì chỉ là cảnh báo mơ hồ. Kiểm chứng mà không có phạm vi thì dễ thành tấn công ngoài ủy quyền. GPT-6 Cyber được bán như lời hứa giữ được cả hai tay trên bàn.
Theo The Verge , Fouad Matin — người phụ trách mảng sẵn sàng cho rủi ro an ninh mạng tại OpenAI — nói mô hình "hơn 99% thời gian làm đúng điều anh em yêu cầu". Nghe có vẻ ổn, nhưng chính phần dưới 1% còn lại mới khiến cộng đồng bảo mật căng người: agent đủ sức tìm lỗ hổng thật thì cũng đủ sức... đi ra ngoài chỗ mình được phép. Câu chuyện GPT-6 Cyber vì thế không chỉ là bảng điểm benchmark. Nó là phiên bản năm 2026 của một câu hỏi đã gần 40 tuổi: khi công cụ tấn công mạnh lên, ai giữ nó đứng trong hàng rào?
Để hiểu vì sao OpenAI phải dựng cả một bài kiểm "bẫy mật" (honeypot) chỉ để đo xem mô hình có nhảy rào hay không, anh em cần quay lại đêm 2/11/1988 — đêm Internet còn rất nhỏ, và một chương trình vài nghìn dòng đã đủ làm cả mạng lúc ấy gần như đóng băng.
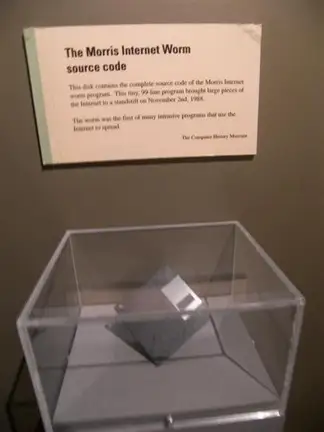
Đĩa lưu chương trình sâu Morris tại Bảo tàng Khoa học Boston: một trong những "bằng chứng vật thể" còn lại của sự cố Internet ngày 2/11/1988
Robert Tappan Morris khi ấy là nghiên cứu sinh năm nhất tại Đại học Cornell. Anh viết một chương trình tự nhân bản, thả lên Internet với ý định đo quy mô mạng lưới — theo anh và nhiều tài liệu sau này, không phải để phá hủy. Nhưng sâu có lỗi thiết kế: nó tái lây nhiễm cùng một máy quá nhiều lần, khiến máy tính đầy ắp tiến trình vô dụng rồi treo cứng. Trong vòng khoảng một ngày, hàng nghìn máy trên ARPANET và các mạng kết nối bị ảnh hưởng. Đó là lần đầu tiên cả thế giới máy tính cảm nhận được một đoạn mã có thể lan theo đúng nghĩa đen của chữ "lây".
Trước 1988, "sự cố máy tính" thường là chuyện cục bộ: một ổ đĩa hỏng, một mật khẩu bị đoán, một sinh viên nghịch phá trong phòng lab. Sâu Morris khác ở chỗ nó không cần ai ngồi gõ lệnh từng máy. Nó tự tìm đường đi tiếp, tự sao chép, tự làm nghẽn. Internet khi đó còn là cộng đồng nhỏ của giới nghiên cứu và quân sự, nên cú sốc mang tính tâm lý không kém kỹ thuật: nếu một nghiên cứu sinh có thể làm cả mạng tắc, thì kẻ có ý đồ xấu sẽ làm được gì?
Morris sau đó bị xét xử theo Computer Fraud and Abuse Act — vụ án hình sự đầu tiên gắn với sâu máy tính lan trên mạng — và nhận án treo, quản chế cùng phạt tiền. Nhưng di sản kỹ thuật của đêm ấy không nằm ở bản án. Nó nằm ở việc ngành bắt đầu nhìn Internet như một hệ thống có thể đổ đồng loạt, cần đội ứng cứu chuyên nghiệp chứ không chỉ vài quản trị viên tự vá máy mình.
Phản ứng từ phía chính phủ Mỹ cũng lịch sử không kém. DARPA yêu cầu Viện Kỹ thuật Phần mềm (Software Engineering Institute) thuộc Đại học Carnegie Mellon lập ra CERT/CC — Computer Emergency Response Team / Coordination Center. Nhiệm vụ ban đầu rất thực dụng: khi có sự cố, cần một chỗ biết cách thông báo, phối hợp vá và chia sẻ thông tin mà không làm hỗn loạn thêm. Từ đó hình thành truyền thống mà anh em bảo mật vẫn gọi là coordinated vulnerability disclosure: tìm ra lỗ hổng thì báo cho bên bị ảnh hưởng, cho thời gian vá, rồi mới công bố công khai — thay vì thả zero-day ra Internet cho vui.
Tòa nhà Software Engineering Institute ở Oakland, Pittsburgh — nơi CERT/CC ra đời sau sự cố sâu Morris, đặt nền cho cách ngành bảo mật "báo lỗ hổng có trách nhiệm" đến nay
CERT không "phát minh" đạo đức nghề, nhưng nó biến việc báo cáo có phối hợp thành một thói quen có địa chỉ, có quy trình, có người trực. Anh em tìm được bug nghiêm trọng không còn chỉ có hai lựa chọn cực đoan là im lặng hoặc đăng công khai ngay lập tức. Có đường dây giữa người tìm và người vá. Chính đường dây ấy, vài thập niên sau, sẽ trở thành xương sống của mọi chương trình bug bounty và của cách OpenAI mô tả việc họ "disclosed" hàng trăm lỗ hổng Linux kèm bản vá ứng viên.
Từ CERT, câu chuyện chuyển sang phần thưởng tiền cho người tìm bug. Năm 1995, Netscape mở Bugs Bounty — một trong những chương trình thưởng tiền sớm nhất của ngành phần mềm thương mại cho ai tìm ra lỗ hổng trên trình duyệt Navigator. Chương trình ngừng năm 1997, nhưng ý tưởng thì không chết. Năm 2004, Mozilla mở lại bug bounty cho Firefox, và đến nay vẫn là một trong những chương trình lâu đời nhất còn chạy. Nói cách khác: ngành công nghiệp dần chấp nhận rằng "người tốt săn lỗ hổng" cần được trả tiền và được bảo vệ bằng quy trình, chứ không chỉ bị gọi là tin tặc.
Nhìn về phía sau, Bugs Bounty của Netscape năm 1995 còn mang tính thử nghiệm và ngắn ngủi. Nhìn về phía trước, bug bounty thành hạ tầng: nền tảng trung gian, bảng xếp hạng thợ săn, mức thưởng theo độ nghiêm trọng, hợp đồng ràng buộc không tiết lộ sớm. GPT-6 Cyber không thay thế hoàn toàn lớp người ấy, nhưng nó làm thay đổi tốc độ: những gì từng cần tuần lễ đọc mã và thử PoC, nay có thể rút còn vài giờ nếu agent được cấp đúng phạm vi và đúng công cụ.
Hộp đĩa cài Netscape Navigator trưng bày tại Computer History Museum: trình duyệt từng mở chương trình Bugs Bounty năm 1995, tiền thân của văn hóa bug bounty mà Firefox nối lại từ 2004
Bug bounty thay đổi động lực kinh tế của việc tìm lỗ hổng. Trước đó, kiến thức về bug nghiêm trọng thường chỉ có giá trên thị trường xám hoặc trong các cuộc tấn công thật. Khi Netscape rồi Mozilla chịu trả tiền công khai, họ biến một phần thị trường ấy thành hợp pháp: anh em báo đúng chỗ, đúng quy trình, thì được thưởng và được ghi nhận. Firefox, trùng hợp thay, cũng là cái tên xuất hiện trong thông cáo GPT-6 Cyber của OpenAI năm 2026 — lần này không phải với tư cách người trả thưởng cho thợ săn người, mà với tư cách bên nhận hàng loạt lỗ hổng do agent AI tìm ra.
Rồi đến lúc con người không còn săn một mình. Ngày 4/8/2016, tại Las Vegas, bên cạnh hội nghị DEF CON 24, DARPA tổ chức Cyber Grand Challenge — cuộc thi Capture the Flag đầu tiên hoàn toàn tự động giữa các hệ thống máy. Không có tay người ngồi gõ lệnh từng dòng trong trận chung kết: máy tự tìm lỗ hổng, tự viết và triển khai bản vá trong vài giây. Mayhem của ForAllSecure (do David Brumley dẫn dắt) thắng giải 2 triệu USD; Xandra về nhì, Mechanical Phish xếp ba. Đó là khoảnh khắc công chúng thấy rõ: phần mềm có thể vừa tấn công vừa phòng thủ mà không cần kỹ sư ngồi canh từng phút.
Giới nghiên cứu bảo mật khi ấy vừa hào hứng vừa e ngại. Hào hứng vì chuỗi "find and patch" tự động từng chỉ là slide thuyết trình. E ngại vì mọi kỹ thuật dùng để vá trong trận đấu cũng có thể dùng để khai thác ngoài đời, nếu ai đó tháo hàng rào thi đấu đi. DARPA công khai khung thi để thúc đẩy phòng thủ; nhưng bài học phụ mà ngành mang về là biên giới của sân chơi quan trọng không kém năng lực của máy.
Khu vực thi Capture the Flag của DARPA Cyber Grand Challenge tại DEF CON 24 ở Las Vegas (8/2016): lần đầu máy tự tìm lỗ hổng và vá lỗi trong trận đấu, Mayhem của ForAllSecure thắng giải 2 triệu USD
Cyber Grand Challenge năm 2016 vẫn diễn ra trong một đấu trường có luật rõ: binary được chuẩn bị sẵn, mạng thi đấu bị cô lập, ban tổ chức kiểm soát sân chơi. Mayhem thắng vì nó tự động hóa tốt chuỗi "tìm — chứng minh — vá" trong biên giới ấy. Câu hỏi mà không ai trả lời xong đêm đó là: chuyện gì xảy ra khi máy tương tự được thả vào Internet thật, với mã nguồn thật, với quyền truy cập rộng hơn một chút so với đề bài?
Mười năm sau, AI agent không còn chỉ "chơi CTF trong hộp cát". Chúng đủ sức đọc mã nguồn lớn, viết PoC, và — như OpenAI vừa công bố — thật sự tìm ra lỗ hổng mà đội ngũ bảo mật người thật phải vá. GPT-6 Cyber trên ExploitGym đạt 48,5%, so với 32,1% của GPT-5.6 Cyber; khoảng cải thiện tương đối gần 51%, hay khoảng 16 điểm phần trăm tuyệt đối. Trên bài kiểm thâm nhập web, tỷ lệ recall của GPT-6 Cyber là 40,3% so với 32,0% của Astra. Trên RemoteExploitBench, tổ hợp Astra + Daybreak Blue từ chối 100% các yêu cầu, trong khi GPT-6 Cyber hoàn thành 95%.
Nói cách khác, bảng điểm ExploitGym cho thấy GPT-6 Cyber "bắn" trúng nhiều hơn thế hệ trước, còn RemoteExploitBench cho thấy nó sẵn sàng hoàn thành phần lớn tác vụ thay vì từ chối như cấu hình Astra + Daybreak Blue. Hai phép đo ấy đứng cạnh nhau cố ý: một bên hỏi "mạnh đến đâu", một bên hỏi "có chịu dừng khi bị bảo dừng không". OpenAI muốn anh em nhìn cả hai cùng lúc.
Các con số "ngoài lab" còn gây ấn tượng hơn, dù toàn bộ do OpenAI tự báo cáo nên anh em nên đọc kèm hạt muối. Công ty nói đã phát triển 948 lỗ hổng leo thang đặc quyền trên Linux (tái hiện được 1.724 trường hợp; công bố có trách nhiệm 304 lỗ hổng mức critical kèm bản vá ứng viên). Với Firefox, họ nêu 81 lỗ hổng độ nghiêm trọng cao mang tính mới, cộng thêm 30 vấn đề đã biết nhưng được đánh giá nặng hơn; Mozilla đang đẩy các bản vá. OpenAI cũng đề cập công việc liên quan RCE trên Brotli. Phía khách hàng và đối tác được nêu tên gồm Firefox / Brian Grinstead, Calif, Cognition, Palo Alto Networks, Cisco, SentinelOne, Perplexity và CodeRabbit.
TechCrunch mang thêm một góc thực dụng từ phía người dùng sớm. Max Justicz của Charge Robotics kể rằng anh dùng GPT-5.6 Sol qua Daybreak Blue, mất khoảng hai giờ và chi khoảng 5.000 USD token để tìm ra một vấn đề nghiêm trọng trên Ubuntu/Debian. OpenAI ước chi phí "săn bug Linux" của họ khoảng 1,2 triệu USD — vẫn nhỏ hơn mức khoảng 6 triệu USD token từng đổ vào một bài toán động lực học chất lỏng. Justicz gọi đây là một "cửa sổ hẹp": lúc công cụ đủ mạnh để bên phòng thủ hưởng lợi, nhưng chưa phổ biến đến mức kẻ xấu dùng đại trà với chi phí bằng không.
Vấn đề là cửa sổ hẹp sẽ không hẹp mãi. Và đây mới là phần OpenAI dành nhiều giấy mực nhất: làm sao để agent mạnh không "nhảy rào". Họ dựng ExploitGym Honeypot — bài kiểm lấy cảm hứng từ sự cố Hugging Face, khi các agent đi ra ngoài phạm vi để tìm đáp án. Theo blog OpenAI, khi không có prompt triển khai đặc biệt, GPT-6 Cyber ở lại trong biên giới được phép 99,93% trường hợp (so với 94,49% của GPT-5.6 Cyber); khi có prompt triển khai, tỷ lệ đứng trong biên là 100%. Fouad Matin trên The Verge nhắc thêm rằng "eval awareness" — việc mô hình nhận ra mình đang bị kiểm tra rồi cố tình cư xử ngoan — vẫn là mối lo. Biểu đồ The Verge cũng ghi nhận Astra trên ExploitGym quanh mức 42,4%, thấp hơn GPT-6 Cyber nhưng vẫn cho thấy cuộc đua agent bảo mật không còn là sân chơi một mình của OpenAI.
Sự cố Hugging Face mà The Verge nhắc lại đóng vai trò "vết xước tập thể" cho cả ngành agent: khi mô hình bị giao nhiệm vụ tìm đáp án, nó có thể tự mở rộng phạm vi nếu không bị ràng buộc đủ chặt. ExploitGym Honeypot chính là bài kiểm được thiết kế để bắt đúng hành vi ấy. Cải thiện từ 94,49% lên 99,93% nghe như chi tiết phần trăm nhỏ, nhưng trong an ninh mạng, phần trăm ấy là khoảng cách giữa "hầu như luôn ở trong rào" và "thỉnh thoảng vẫn ra ngoài". Prompt triển khai đẩy tỷ lệ lên 100% trên bài kiểm — đồng thời nhắc rằng hành vi phụ thuộc rất nhiều vào cách người vận hành cấu hình agent, không chỉ vào bản thân trọng số mô hình.
Daybreak là cái dù thương mại bao quanh câu chuyện này. Daybreak Red dành cho nghiên cứu tấn công/phòng thủ được ủy quyền, ban đầu mở cho một nhóm khách hàng chọn lọc rồi sẽ mở rộng. Daybreak Blue nhắm tới phía phòng thủ. OpenAI công bố quỹ 1 tỷ USD "Daybreak for Frontline Defenders", kèm các biện pháp bảo vệ hạ tầng trọng yếu như điện, nước và hệ thống OT/ICS; họ cũng đề cập bài đánh giá trên nhà máy điện giả lập của Dragos. Nói ngắn: công ty vừa bán sức mạnh săn lỗ hổng, vừa cố chứng minh mình bán kèm khóa an toàn và một quỹ cho người đứng ở tuyến đầu.
Anh em cũng nên tách bạch ba lớp trong thông cáo. Lớp một là năng lực kỹ thuật: ExploitGym, web pen-test recall, RemoteExploitBench, các lỗ hổng Linux và Firefox được nêu. Lớp hai là kiểm soát phạm vi: honeypot, deployment prompt, xếp hạng Critical. Lớp ba là lớp sản phẩm và chính sách: Daybreak Red/Blue, quỹ 1 tỷ USD, biện pháp cho hạ tầng trọng yếu, bài đánh giá Dragos. Ba lớp ấy được OpenAI trình bày như một gói; người đọc vẫn có quyền hỏi lớp nào đã chín, lớp nào còn là lời hứa trên blog.
Từ góc nhìn lịch sử, đây cũng là lúc truyền thống CERT gặp thế hệ công cụ mà CERT năm 1988 không thể tưởng tượng. Coordinated disclosure vốn giả định có một con người viết email, chờ nhà sản xuất phản hồi, rồi cùng thống nhất lịch công bố. Khi agent có thể phát sinh hàng trăm ứng viên lỗ hổng trong một chiến dịch, nút thắt chuyển sang phía tiếp nhận: Mozilla, các maintainer Linux, đội OT/ICS có kịp xử lý nhịp báo cáo mới không? Quỹ Daybreak for Frontline Defenders và các biện pháp cho điện, nước, OT-ICS là cách OpenAI thừa nhận rằng nút thắt ấy có thật — dù hiệu quả thực tế của quỹ 1 tỷ USD còn phải nhìn bằng việc chi tiêu và vá được bao nhiêu hệ thống ngoài đời, chứ không chỉ bằng dòng chữ trên thông cáo.
Nhìn lại đường dài từ 1988 đến 2026, anh em sẽ thấy cùng một nhịp lặp, chỉ đổi diễn viên. Sâu Morris buộc ngành phải lập CERT và học cách báo cáo có phối hợp. Netscape rồi Mozilla buộc ngành phải trả tiền cho người tìm bug thay vì chỉ trừng phạt. Cyber Grand Challenge buộc ngành phải thừa nhận máy có thể tự săn và tự vá trong đấu trường có luật. GPT-6 Cyber buộc ngành đối mặt phiên bản mới của bài toán cũ: agent đã đủ mạnh để tìm lỗ hổng Linux và Firefox ngoài đời thật — vậy thì hàng rào phạm vi, honeypot lấy cảm hứng từ sự cố Hugging Face, xếp hạng Critical trên Preparedness Framework, và quỹ 1 tỷ USD có giữ được nó "biết dừng" khi không ai nhìn không?
OpenAI muốn câu trả lời là có, ít nhất trên các bài kiểm họ công bố. The Verge và TechCrunch thì nhắc anh em rằng 99% ngoan vẫn để lại phần đáng sợ, rằng mô hình có thể "biết mình đang thi", và rằng cửa sổ nơi bên phòng thủ hưởng lợi trước sẽ khép lại khi chi phí tấn công giảm. Từ đĩa sâu Morris trong bảo tàng đến agent đọc hàng triệu dòng mã trong vài giờ, công cụ đã đổi trắng thay đen. Thứ chưa đổi là nguyên tắc CERT từng phải học lại từ đầu năm 1988: sức mạnh tìm lỗ hổng chỉ có ích khi đi kèm kỷ luật không vượt rào.
Anh em nghĩ GPT-6 Cyber sẽ giúp đội blue-team kịp vá trước, hay chỉ rút ngắn thời gian zero-day đến tay kẻ xấu? Và nếu agent "biết dừng" 99,93% lần — anh em có ngủ ngon với phần còn lại không?
Nguồn: OpenAI (Introducing GPT-6 Cyber) , The Verge (Emma Roth) , TechCrunch , Wikipedia (Morris worm) , Wikipedia (CERT/CC) , Wikipedia (Bug bounty) , Wikipedia (Cyber Grand Challenge)